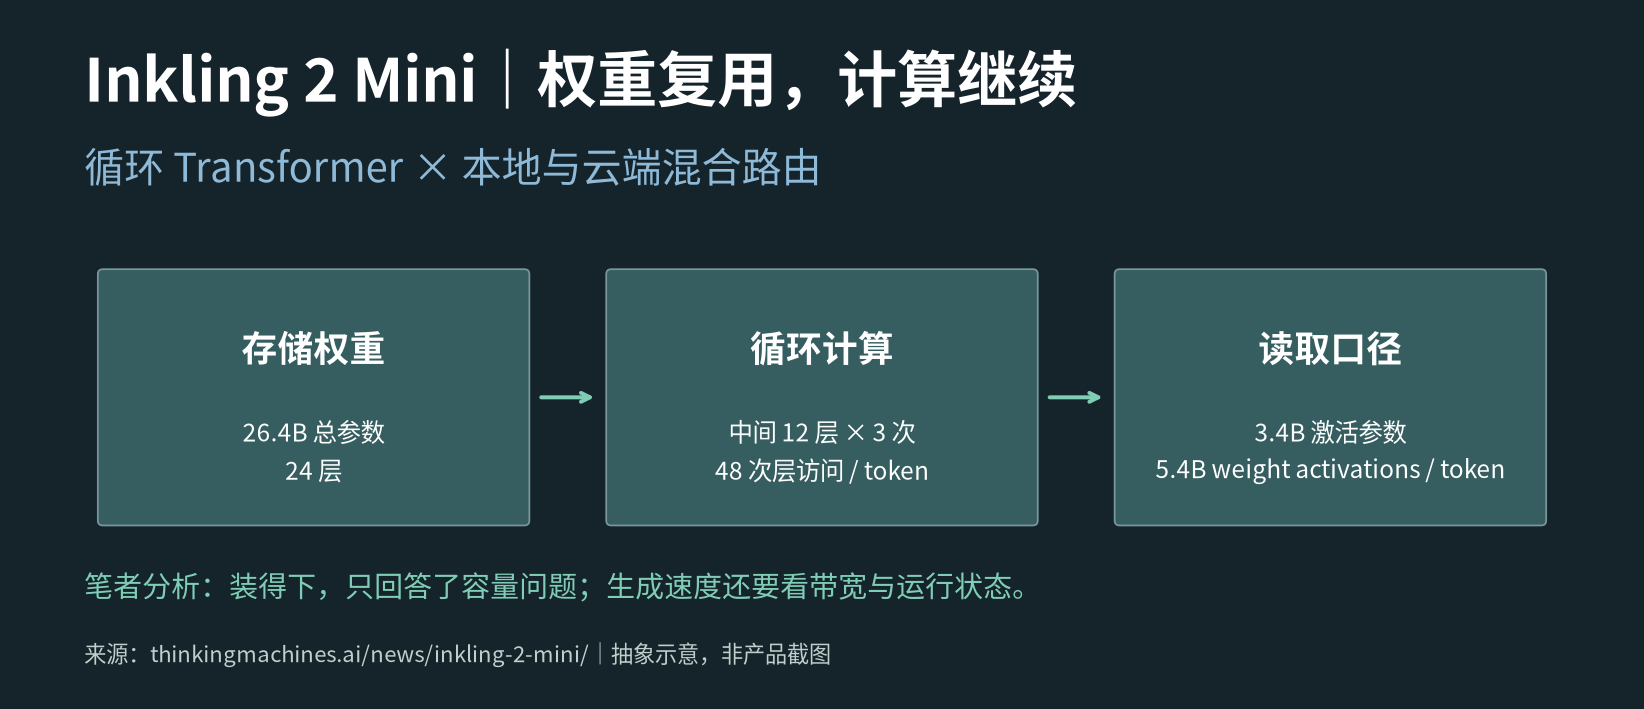
Thinking Machines Lab 11 月 20 日发布开放权重模型 Inkling 2 Mini:多模态 MoE,总参数 26.4B、激活 3.4B,HF 博客注明支持 1M 上下文,官方称总内存约 20GB,演示了离线 MacBook Pro 运行。
循环 Transformer:小的是权重,不是计算
它只存 24 层权重:前 6 层、后 6 层各跑一次,中间 12 层共享权重循环 3 次,每 token 共 48 次层访问。所以要分清三个数:26.4B 总参数、3.4B 激活参数、5.4B 计入循环后的每 token 权重激活量。官方解码速度图是 BF16、614 GB/s 带宽下的理论上限,不是笔记本实测。
笔者看法:循环省了存储容量,没省重复访存。选型别只看“激活参数小”,要实测生成速度、首字延迟和任务总耗时。
CoT 变短,监督不能放松
团队自报:GPQA Diamond 子集上,1 轮与 5 轮的平均推理长度从 3,703 降到 1,661 token。更多推理发生在输出之前,只读 CoT 的监督有盲区;工具调用、执行结果和权限边界仍要由应用记录和把关。
本地一行启动
llama serve -hf ggml-org/Inkling-2-Mini-GGUF:IQ4_NL
本地 + 云端混合路由
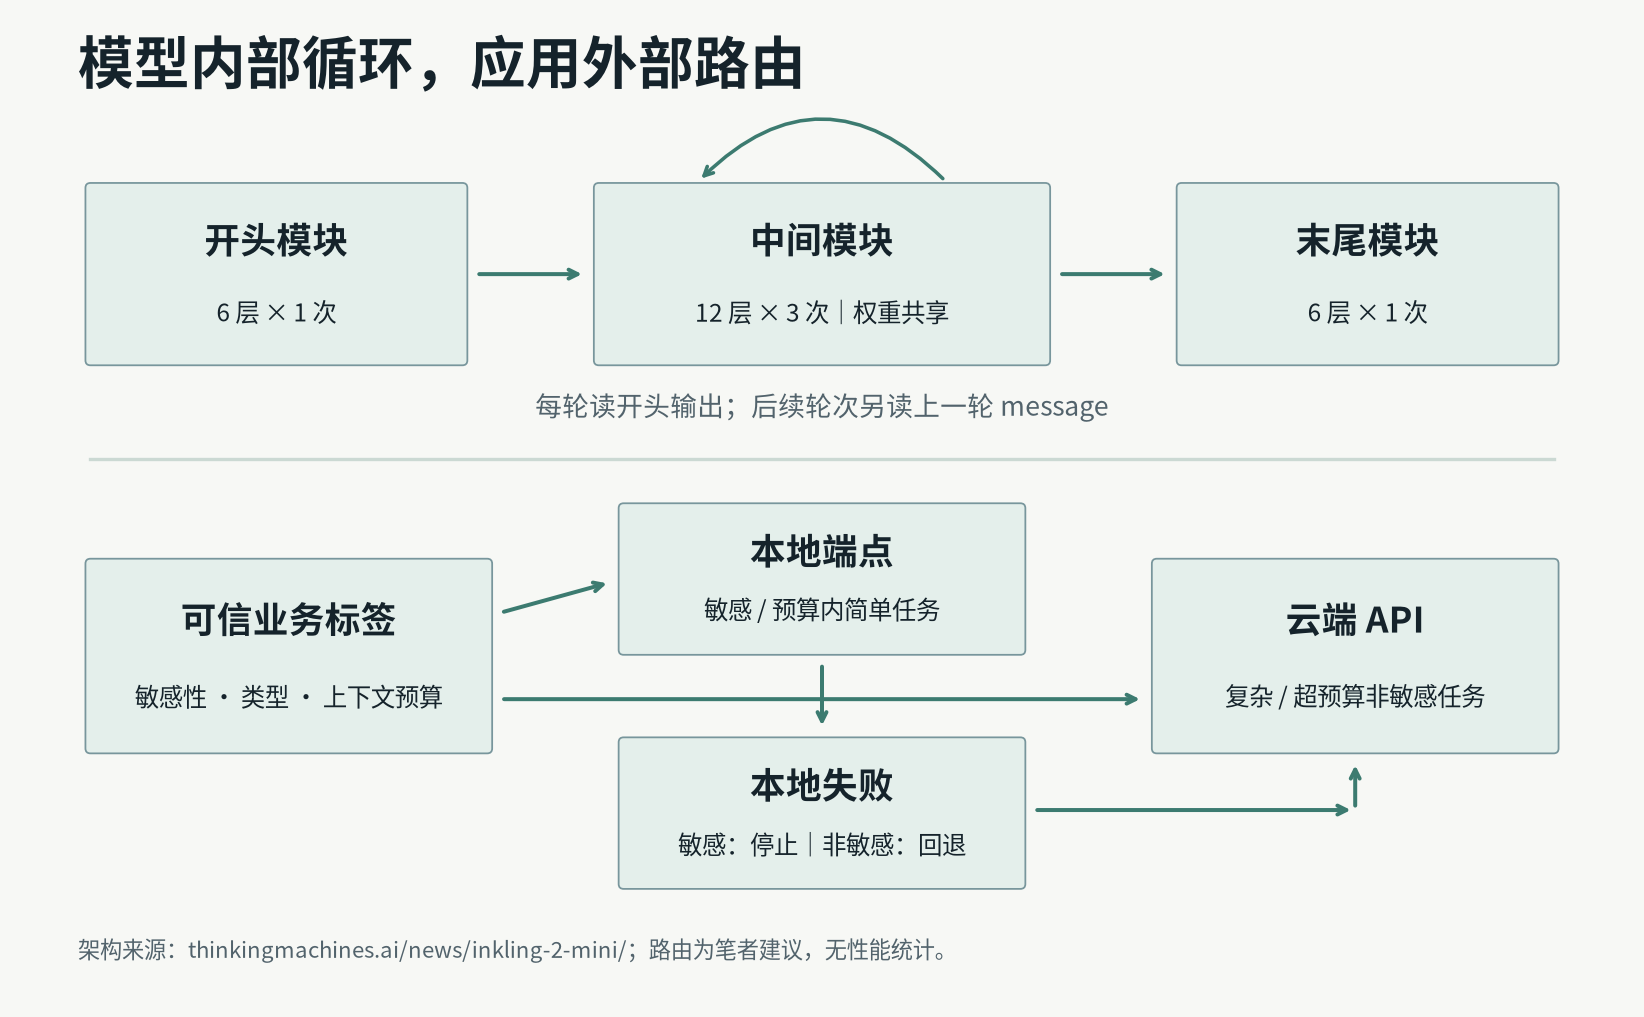
建议:敏感数据只走本地,本地失败就报错,不静默上传;简单任务(分类、抽取、短文改写)走本地,复杂或超出本机上下文预算的非敏感任务走云端 API中转站(OpenAI 兼容):
cloud = OpenAI(base_url="https://big-model.smart-agi.com/v1",
               api_key=os.environ["TWINKLE_API_KEY"])
完整路由代码与部署细节见原文。官方自报 DeepSWE v1.1 48.2%,也承认多轮对话、复杂约束仍有短板——上线前请用自己的任务测。
参考:https://thinkingmachines.ai/news/inkling-2-mini/ | https://huggingface.co/blog/inkling2mini
作者说明:作者在运营 API中转站 Twinkle Model(https://big-model.smart-agi.com),GPT 1折、国模1折、满血 Claude、源头中转、低价稳定,价格见模型广场 https://big-model.smart-agi.com/model-plaza 。