11 月 18 日,谷歌发了 Gemini 4 Neon。
这是一个月内的第四款 Gemini 4 模型。前面三款是 Hydrogen、Argon、Carbon,Neon 由 Carbon 适配衍生而来,定位卡在两者中间,主攻复杂编程、科学研究和企业工作流。
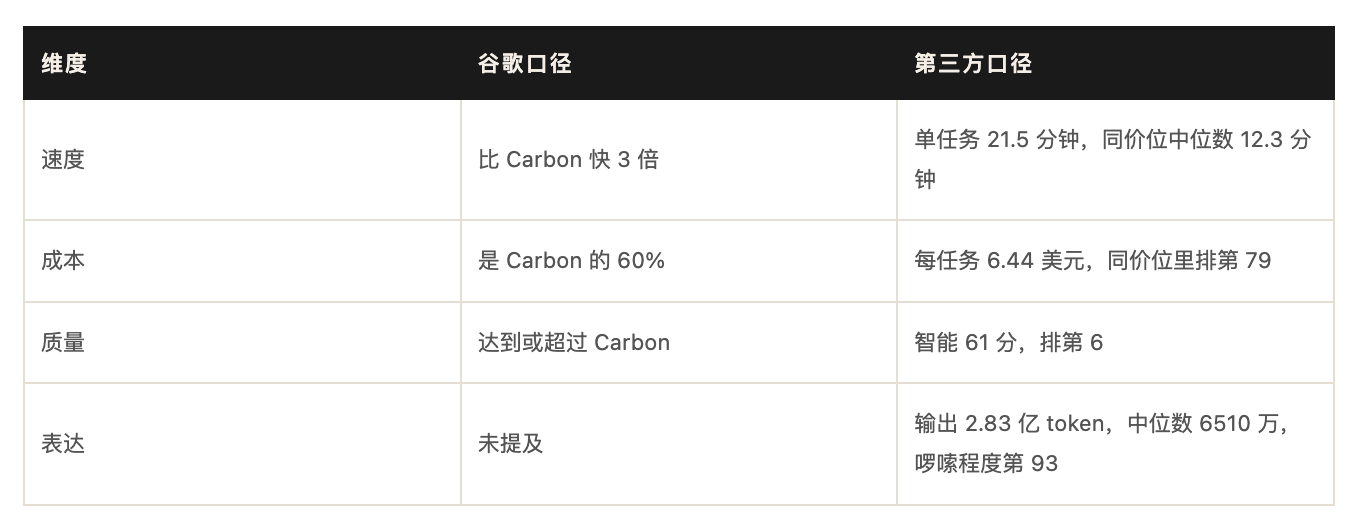
谷歌给的说法很漂亮。任务质量达到或超过 Carbon,速度快三倍,成本只有六成。默认 high 档下单任务成本比 Carbon 低 32%。
我去看第三方数据的时候,看到的完全是另一幅画面。
官方那份成绩单 {en="GOOGLE"}
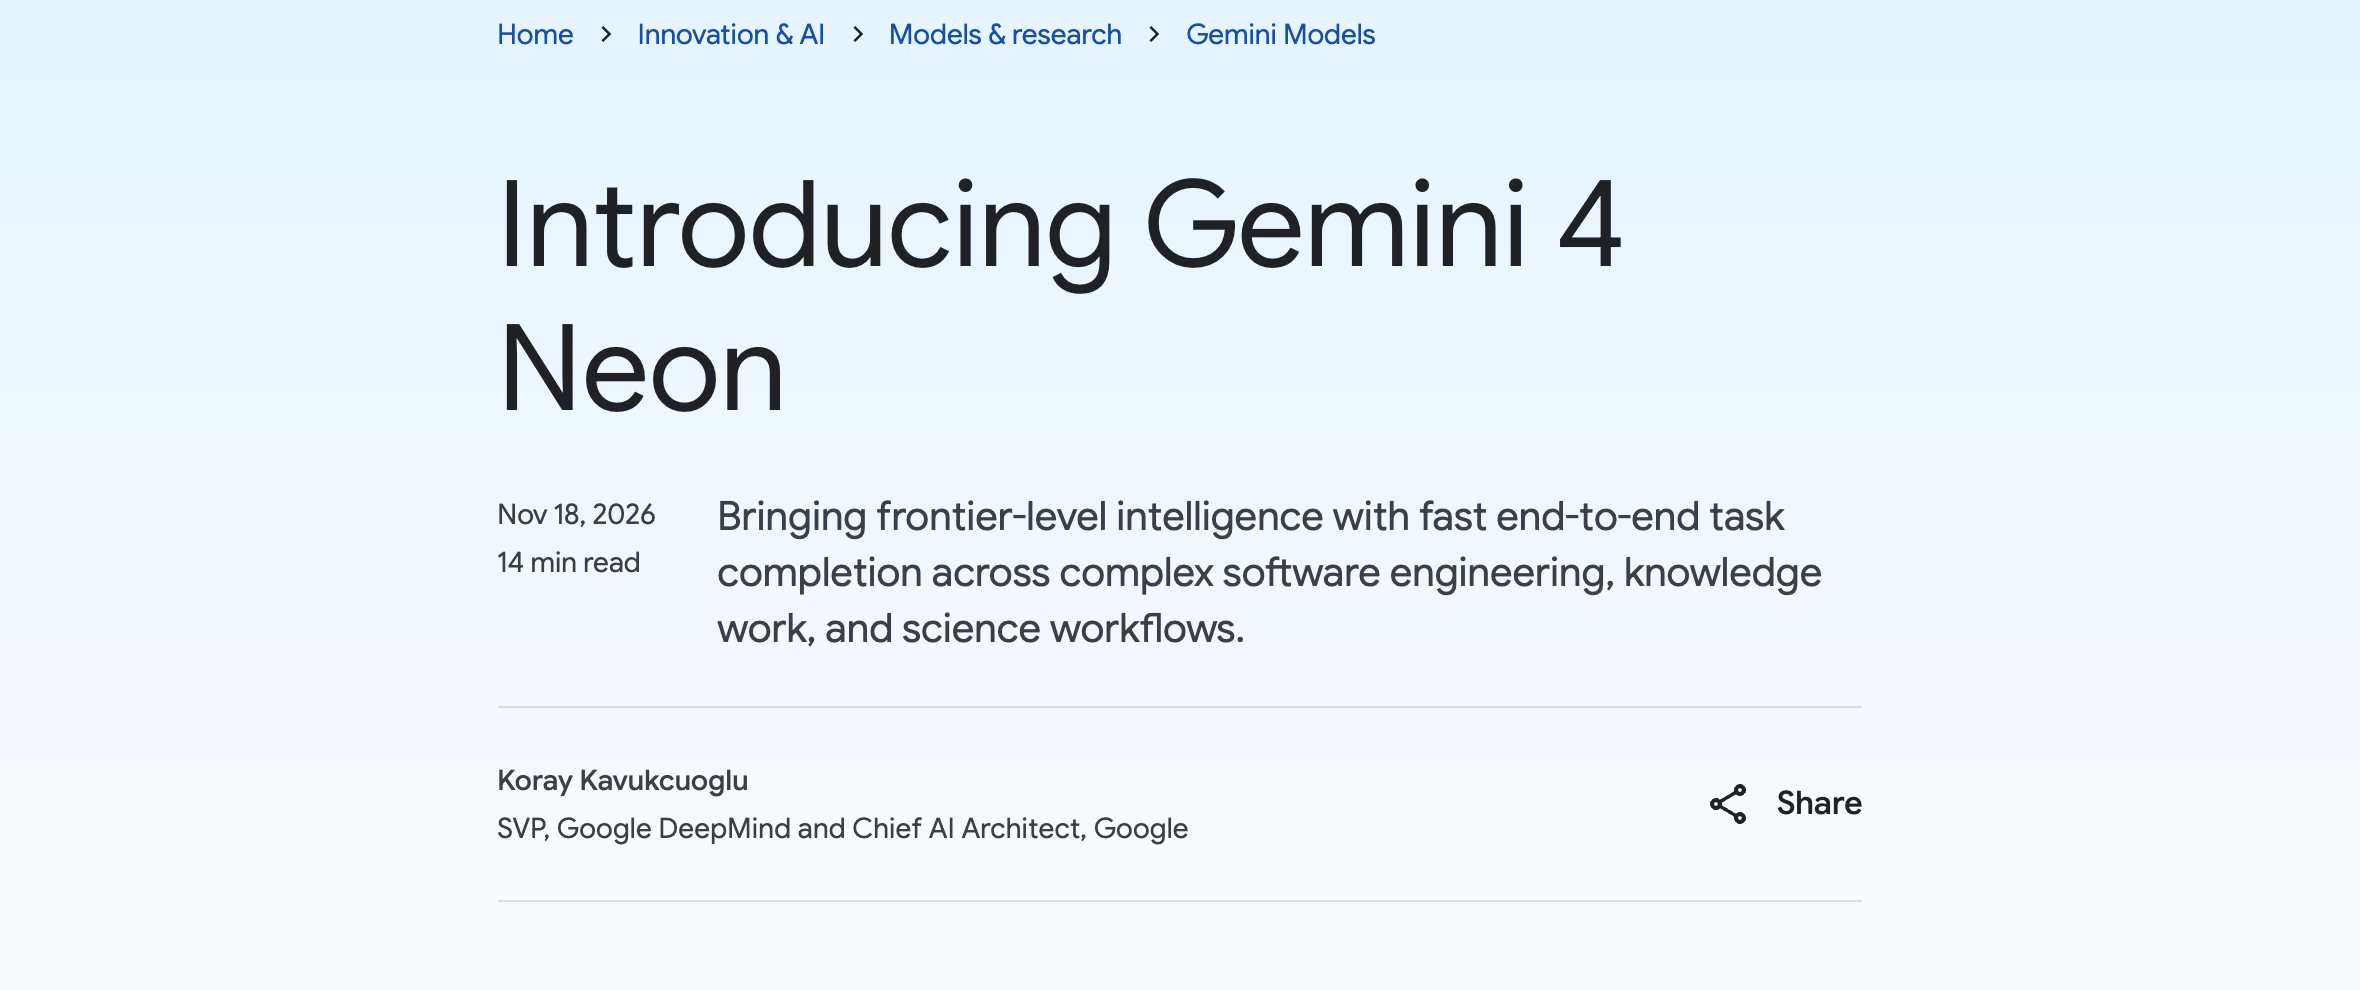
谷歌官方博客那篇原文,标题叫 Introducing Gemini 4 Neon,署名是 DeepMind 的 SVP 兼首席 AI 架构师 Koray Kavukcuoglu。
先把硬指标摆出来。
定价是输入每百万 token 3 美元,输出 15 美元,缓存输入 0.15 美元。这个价比 Carbon 和 Argon 最初的 2 美元和 10 美元贵,但它们 12 月 1 日要涨到 4 美元和 20 美元,涨完 Neon 反而便宜。
上下文 100 万 token,最多生成 100 万 token 输出。支持文本、图像、视频、音频、PDF,能计算机操控、执行代码、搜索文件,还能调 Google 搜索和地图做事实核验。图像和音频生成不支持。
推理分四档,Low、medium、high、xhigh。
跑分上谷歌列了一长串。Artificial Analysis 智能指数在 xhigh 档拿 61 分,Vals Index 第二,处于帕累托前沿。编程智能体指数 58.6 分,第一。Agent Arena 那项 1336 分,全球第二,其中可操控性排第二,讲的是你在任务中途改要求,它能不能跟上。
细分场景里第一更多。法律研究基准第一,税务智能体第一,Surge AI 的金融、会计、电子表格建模、复杂约束遵循多数第一,Zapier 的 AutomationBench 56.3% 第一,Andon Labs 的 Vending-Bench 2 第一。Terminal-Bench Science 70.5%,RiemannBench 84.0%,HLE-Diamond 71.3%,都是同类最佳。
还有一句值得一提。在 Antigravity 的内部测试里,Neon 的幻觉率创下谷歌的最低水平。
官方博客里挂了张完整对照表,把 Neon 和 Claude Opus 5.5、GPT-6.2 Sol 放在一起比。
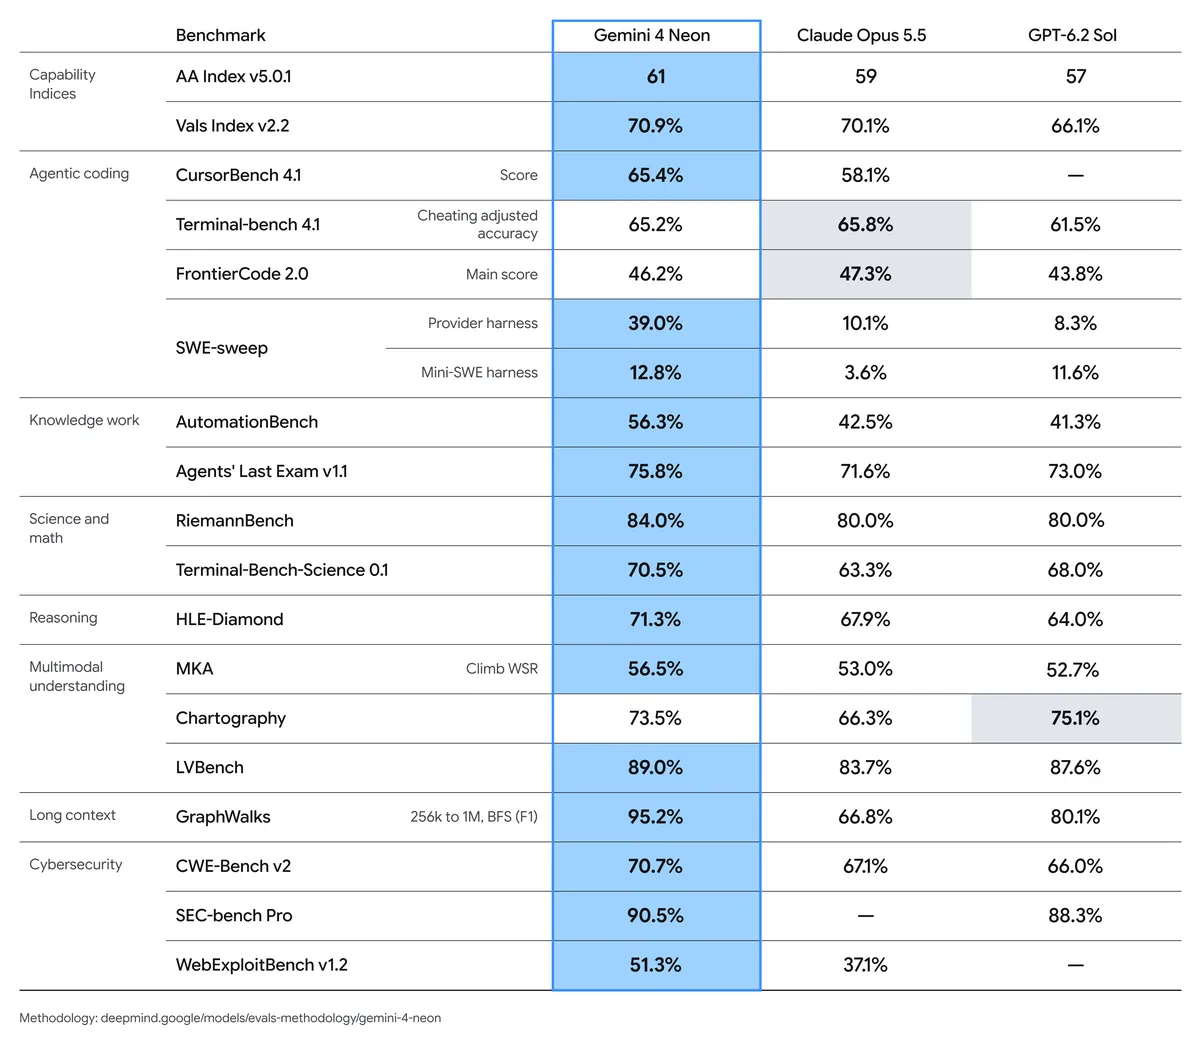
这张表比前面那一串「第一」诚实。
表里有三项用灰底标了出来,意思是竞争对手更强。Terminal-bench 4.1 上 Opus 5.5 拿 65.8%,Neon 是 65.2%。FrontierCode 2.0 上 Opus 5.5 是 47.3%,Neon 是 46.2%。Chartography 上 GPT-6.2 Sol 是 75.1%,Neon 是 73.5%。
三处都是小差距,但都在。谷歌自己没藏。
表里还有几个数字挺说明问题。GraphWalks 那项测长上下文,256K 到 1M 的 BFS 召回,Neon 95.2%,Opus 5.5 只有 66.8%,GPT-6.2 Sol 80.1%。SWE-sweep 上差距拉得更大,Neon 39.0%,Opus 5.5 是 10.1%,Sol 是 8.3%。
第三方那份成绩单 {en="THIRD PARTY"}
我打开 Artificial Analysis 的模型页,第一屏就给人泼了冷水。
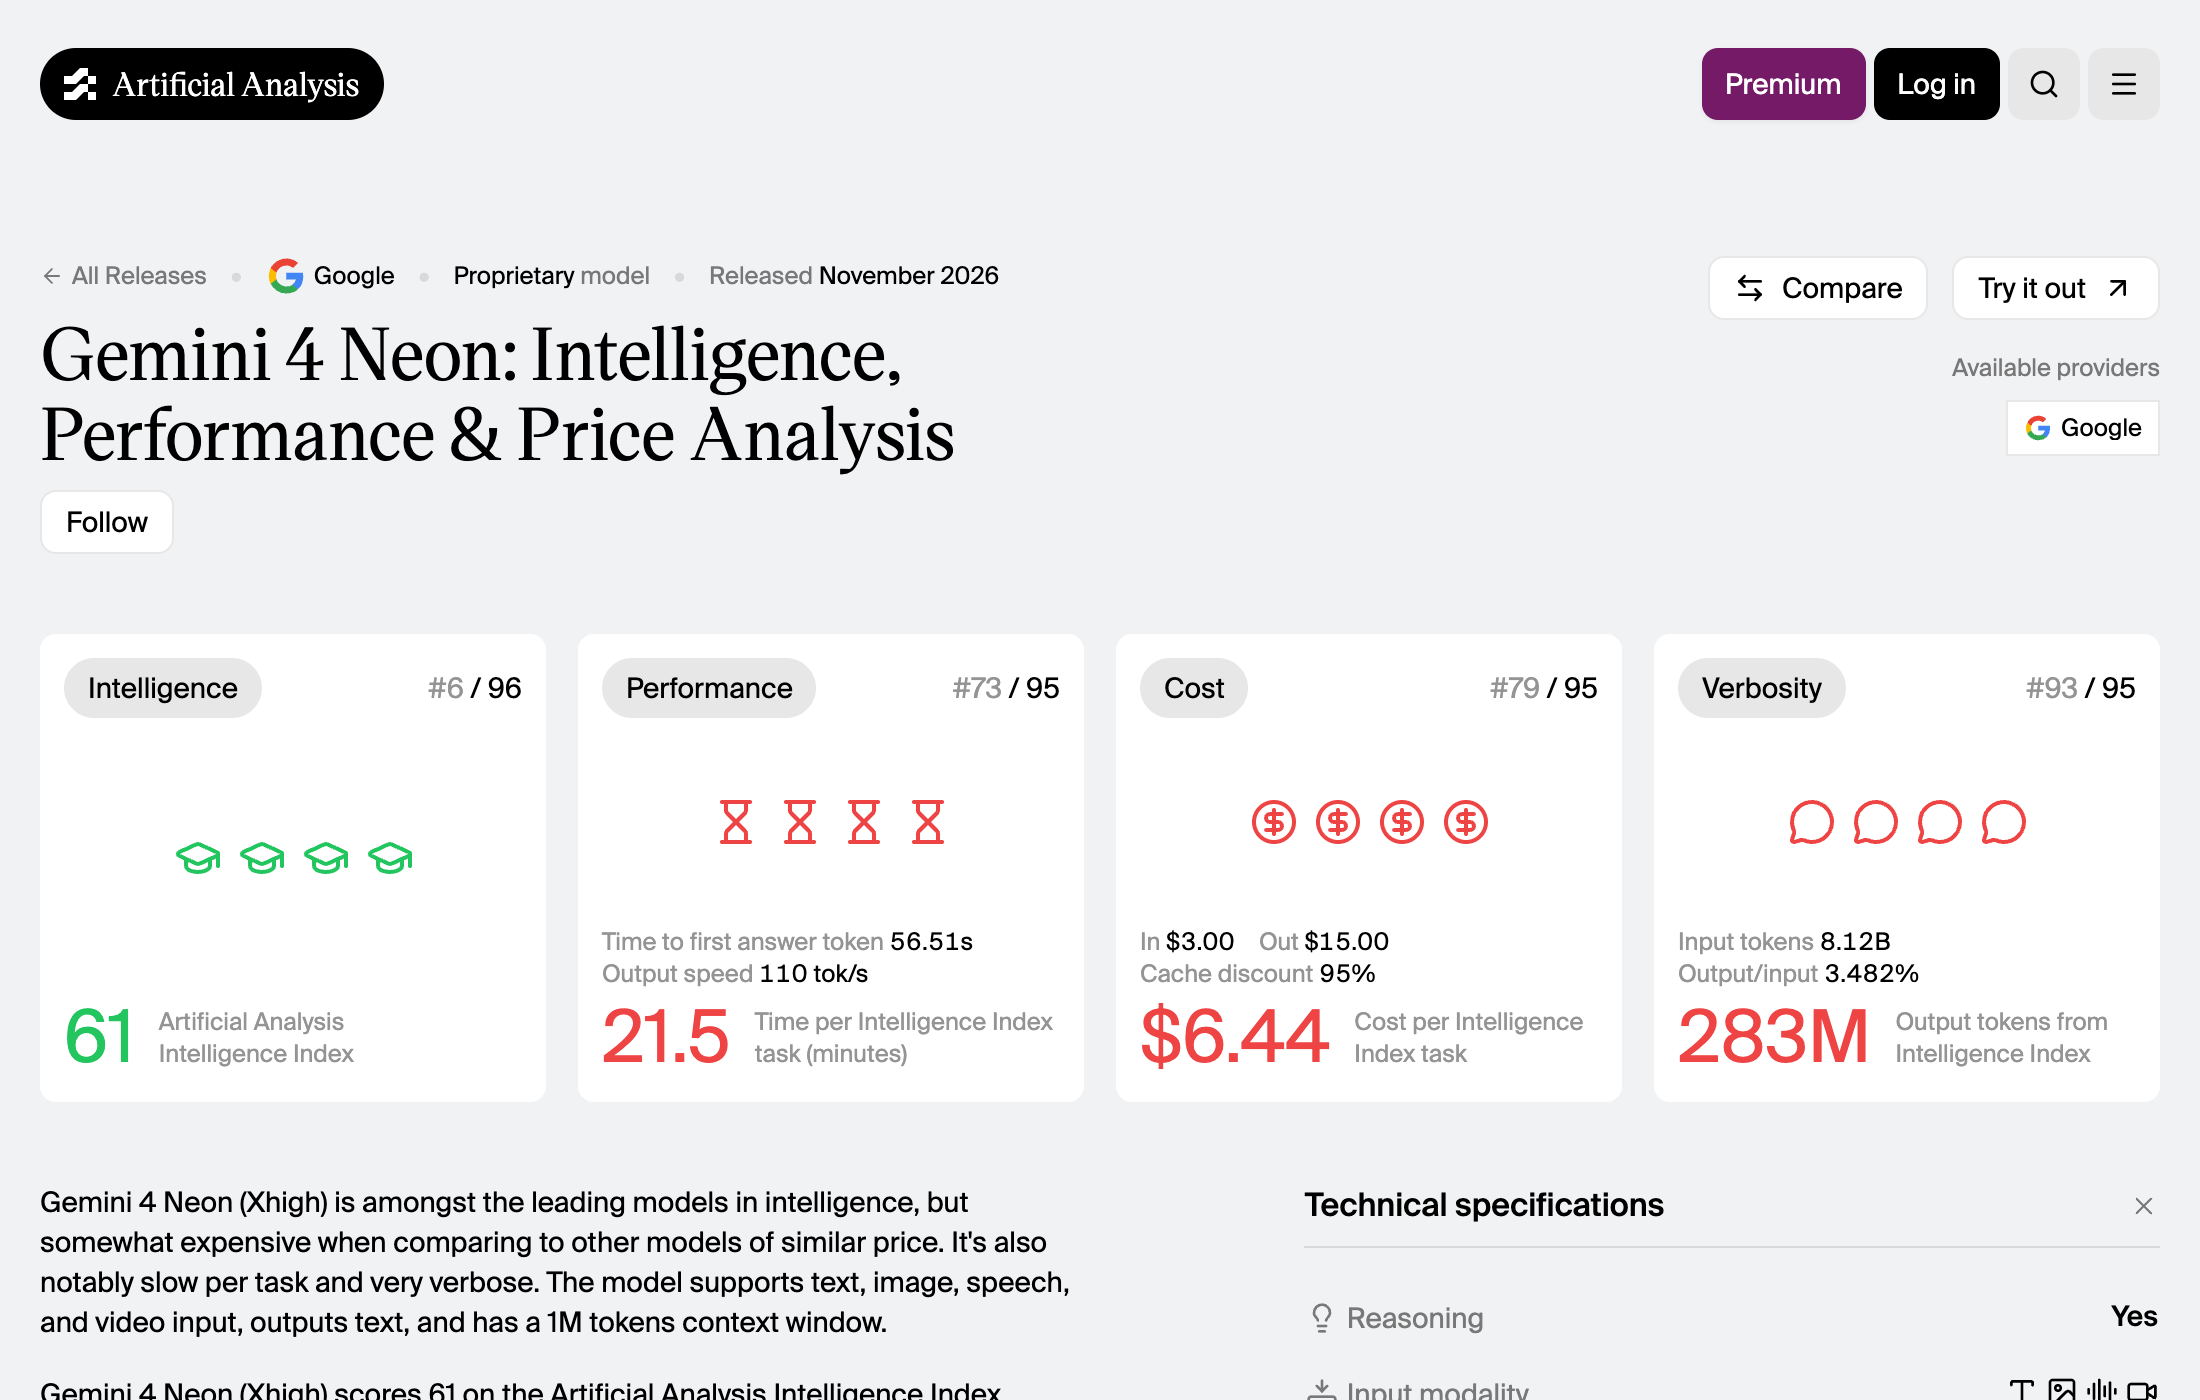
智能那项确实好。61 分,在 96 个模型里排第 6。这个成绩没问题。
往下看就变味了。
性能排第 73,一共 95 个模型。首字延迟 56.51 秒,输出速度倒是快,110 token 每秒,但每个智能指数任务要跑 21.5 分钟。AA 给的同类可比模型里,这个数字的中位数是 12.3 分钟。
成本排第 79。每任务 6.44 美元。同价位模型里这个偏贵。
最扎眼的是最后一张卡,Verbosity,第 93 名。评测过程中它输出 2.83 亿 token,而可比模型中位数是 6510 万。
四倍多。
AA 的评语写得很直接。智能上属于领先水平,但跟同价位模型比偏贵,每个任务明显慢,而且非常啰嗦(very verbose)。
两份成绩单其实不矛盾 {en="WHY"}
我琢磨了一下,两边都没撒谎。
谷歌说的快三倍、成本六成,比的参照物是自家 Carbon。Carbon 是旗舰,块头更大、更慢,Neon 在它面前确实又快又便宜。这个对比成立。
AA 比的参照物是同价位竞品。在这个池子里,Neon 的单价不低,输出量还大,最后摊到每个任务上就显得又慢又贵。这个判断也成立。
第三方那张图把这件事讲得更清楚。
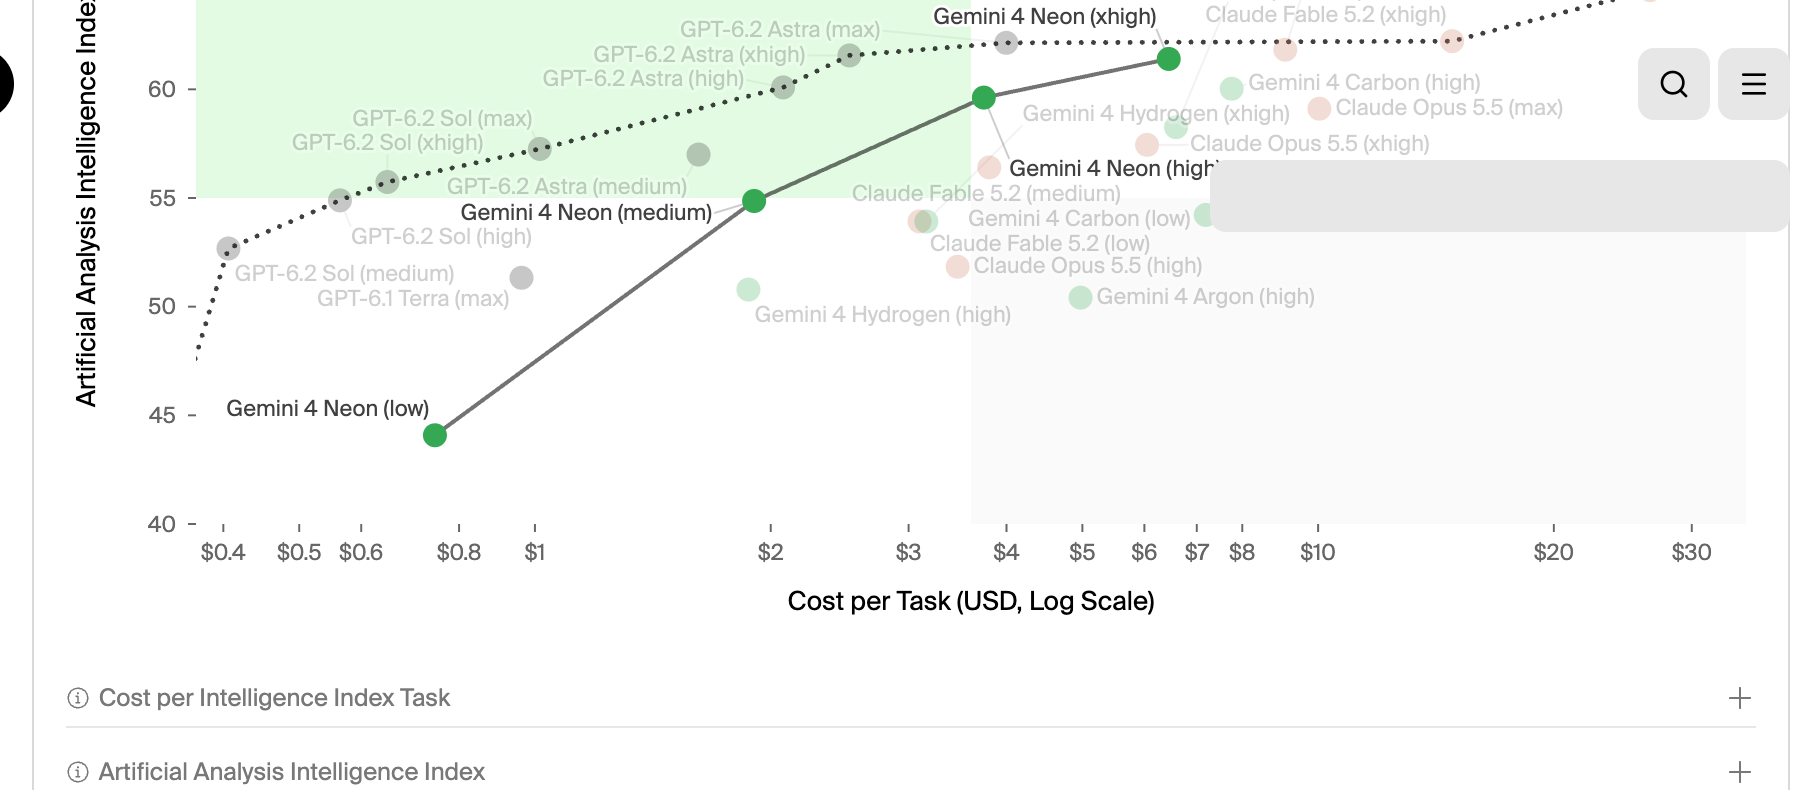
Neon 分了四个档位,价格从每任务 0.8 美元一路到 6.4 美元,分数从 45 爬到 61。曲线在前三档很陡,最后一段突然变平。
从 high 档到 xhigh 档,多花 2.4 美元,只换来 2 分。
同样在这张图上,GPT-6.2 Astra 的最高档是 62 分、5.5 美元。也就是说 Neon 要想拿 61 分,花的钱比它拿 62 分还多。
这就是 AA 说「同价位偏贵」的具体位置。
谷歌官方博客里也有一张,画的是一模一样的坐标。
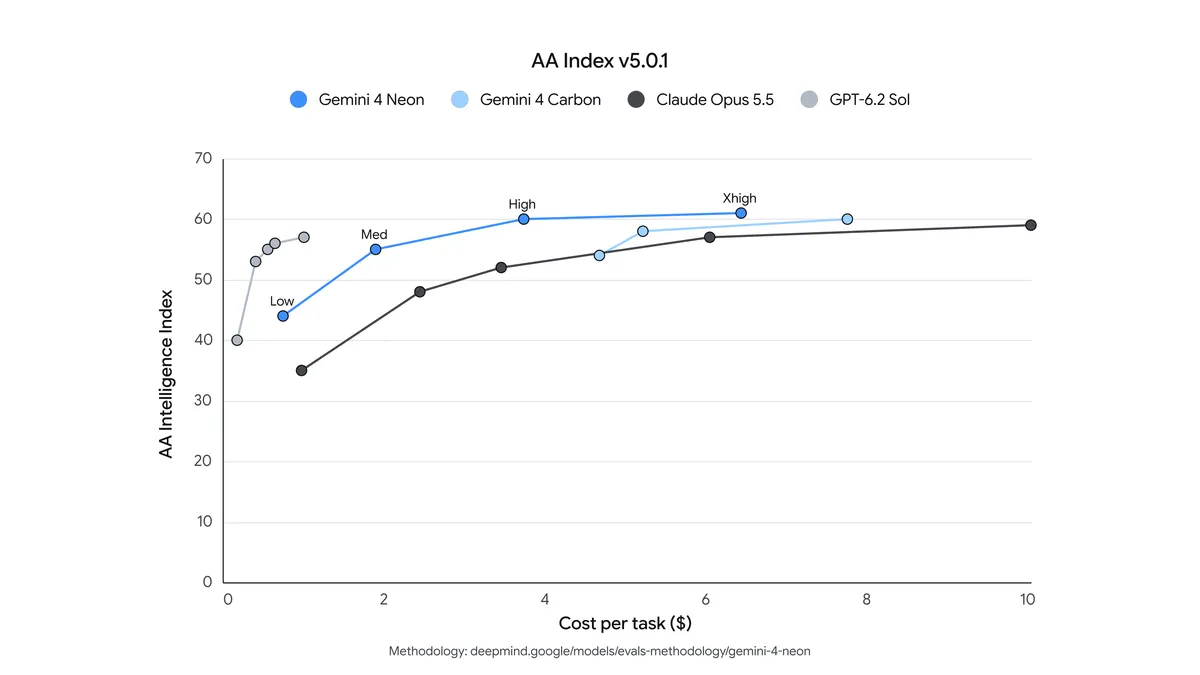
有意思的是,这张图是谷歌自己画的。
图里最左侧那一簇密集的灰点是 GPT-6.2 Sol。它最高只到 55 分,但代价不到 1 美元。Neon 要到 60 分得花 3.7 美元,到 61 分得花 6.3 美元。
也就是说,多花四到六倍的钱,买回来五到六分。
谷歌画这张图是想说明 Neon 那条蓝线在帕累托前沿上,结果也顺手把对手的位置画出来了。
真正解释一切的,是那个第 93 名。
一个模型如果话特别多,会同时拖垮三件事。输出多,token 就多,账单跟着涨。输出多,生成时间就长,单任务耗时被拉长。输出多,读的人还得自己筛重点。
所以问题出在表达方式上,跟能力关系不大。
这件事对用的人有实际影响。同样一个任务,如果它给你三千字而你只需要三百字,省下的钱买不到省下的注意力。
顺手改了产品线 {en="LINEUP"}
这次发布还带来一串变动,我觉得比模型本身更值得看。
Neon 上线后,3.1 Pro 正式下线,Argon 被 Neon 取代。3.5 Flash-Lite 在付费用户的模型选择器里改名叫 Auto。
重排之后,选择器变成四个格子。Auto 按需求自动适配,日常辅助对应 4 Hydrogen,深度分析对应 4 Neon,代码与复杂工作对应 4 Carbon。
注意这个分法。以前是一个模型打天下,型号越大越强,用户按预算选。现在是按任务类型分,每类任务配一个最合适的。命名也从版本号换成了元素名。
一个月发四款,把老型号清出去,这个节奏说明他们在把产品线从「能力阶梯」改成「分工矩阵」。
顺带一提,同一天谷歌还把 Genie 4 正式放出来了。这是世界模型,能生成可交互的 3D 世界,之前只做研究预览。现在向 Google AI Ultra 订阅用户开放,可以用文本指令实时改天气、改角色、改剧情,还能原生生成实时音效。
我的判断 {en="MY TAKE"}
Neon 这代模型的竞争方式,我觉得在变。
过去比的是谁的分数高。现在分数挤在一起,61 分和 60 分的差距意义不大,真正拉开体验的是三件事,跑一次多少钱、等多久、出来的东西要不要人再加工一遍。
Neon 在前两项上的账面数字很好看,第三项被 Verbosity 那张卡揭了底。
所以我的建议是,如果打算用,先别按官方口径估预算。拿你自己的真实任务跑十次,看它平均吐多少字、花多少时间、你要删掉多少。这三个数字比任何跑分都准。
谷歌自己也在调整。四款模型分工、下线老型号、把 Auto 摆到第一位,这些动作都指向同一件事,他们意识到用户要的是最合适,未必是最强。
至于 Neon 能不能在这个位置上站住,得看下一版会不会收敛它的表达欲。
拿走清单
别只看智能指数。同一张页面上,性能排 73、成本排 79,这两个数字才决定日常体验。
先算输出量。Verbosity 第 93 名说明它话多,输出 token 直接决定账单,四倍输出就是四倍价钱。
首字延迟 56 秒要提前有心理准备。xhigh 档思考时间长,适合跑批任务,不适合等在那儿看。
官网说的「快三倍」是跟自家 Carbon 比,不是跟同价位竞品比。这个参照系要先问清楚。
如果是日常辅助,Hydrogen 更划算。Neon 的定位是深度分析,杀鸡不用牛刀。