短版摘要:Gemini Omni 1.2 Flash 将原生视频生成与编辑延长到 15 秒,官方称价格较前代降低 30%。但每
秒报价只是视频输出 token 的近似换算,多轮编辑也没有公开的统一省钱比例。开发者应分清草稿、改稿与放大的开销,更不能把 Google Vids 的免费额度当成付费 API 的赠额。
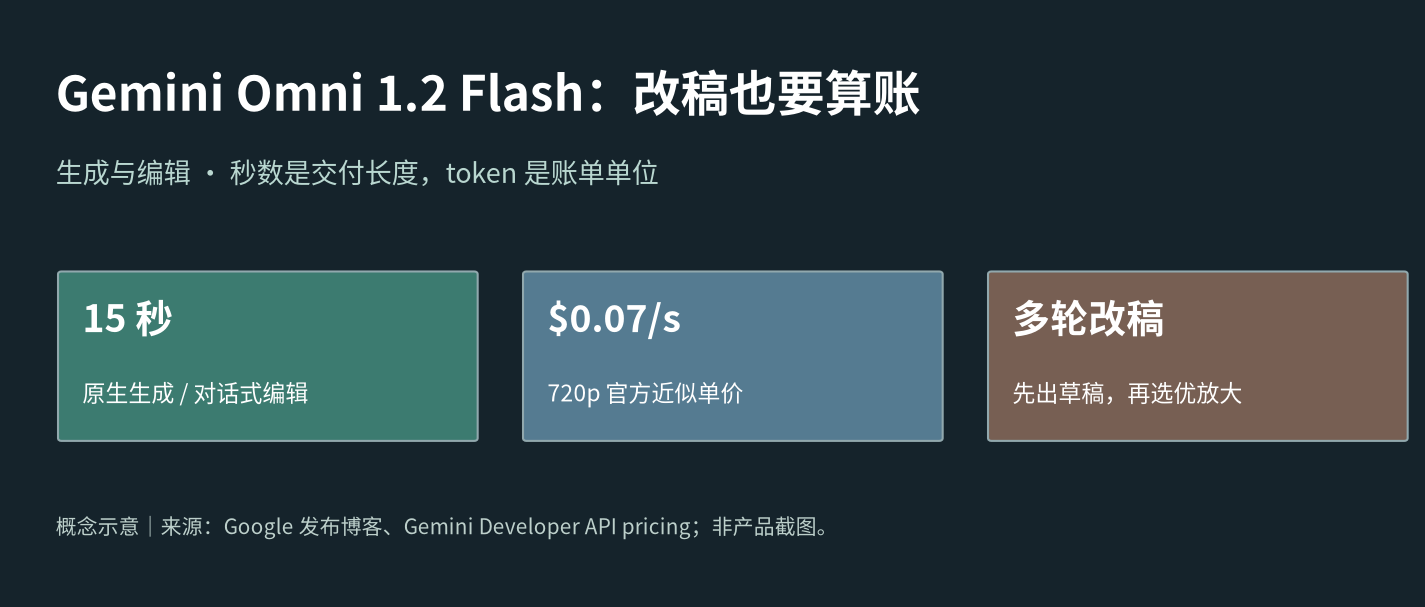
视频模型降价,最容易带来的错觉是:把成片时长乘上单价,就能知道项目预算。真正做过内容迭代的人会先问,预算里包含多少次废稿,以及局部修改是否需要重新生成整段。我的判断是,这次更新值得关注的地方,是更长片段与对话式编辑能否组织成可控的生产流程;价格只是这个流程的起点。
最长片段变长,不等于复杂镜头都能放心交付
Google 发布博客由 Google DeepMind 产品经理 Anish Nangia 撰写,发布于 2026-11-05。Omni 1.2 Flash 原生生成和编辑最长 15 秒,前代 Omni 1.1 为 10 秒;可在 3 到 15 秒之间按 1 秒步进指定长度,并已在 Gemini API 与 Gemini for business 一般可用。
长度可调对开发者有实际意义:先按脚本确定需要的节奏,再申请对应长度,比默认生成最长片段更有预算意识。但片段更长也意味着人物、产品和动作连续性需要接受更完整的检查,不能只挑开头画面验收。
官方称,参考输入可以组合角色、产品或风格图,最长 3 秒的短动作片段,以及音频提示,并强调全片细节保持。这里应保留厂商表述的边界:Cloud 同期说明指出音频参考需要 allowlist,不能看到发布演示就默认所有账号都能直接使用。
对白更自然、对口型更清晰、多说话人条件可区分,也都是官方能力描述,本文没有独立复现。发布博客同时承认快速体育动作、快速剧本切换和复杂物理仍在改进。涉及这些镜头时,我会先验证核心动作,再补布景和风格,避免把美术完成度误当成动作可靠性。
每秒报价是换算结果,账单基础仍是 token
Gemini Developer API 定价页列出的模型 ID 是 gemini-omni-1.2-flash,免费档不可用。付费档文本、图像和视频输入为 $1.50 / 1M tokens;输出包含 thinking tokens,文本为 $9.00 / 1M,视频为 $12.00 / 1M。
720p 视频输出对应每秒 5,792 tokens,按视频输出标准价换算约为 $0.07/秒。官方也给出约 $0.70 / 10 秒、约 $1.04 / 15 秒的口径。这些是视频输出项的近似费用,不能直接称为包含提示词、参考素材和所有编辑轮次的任务总价。
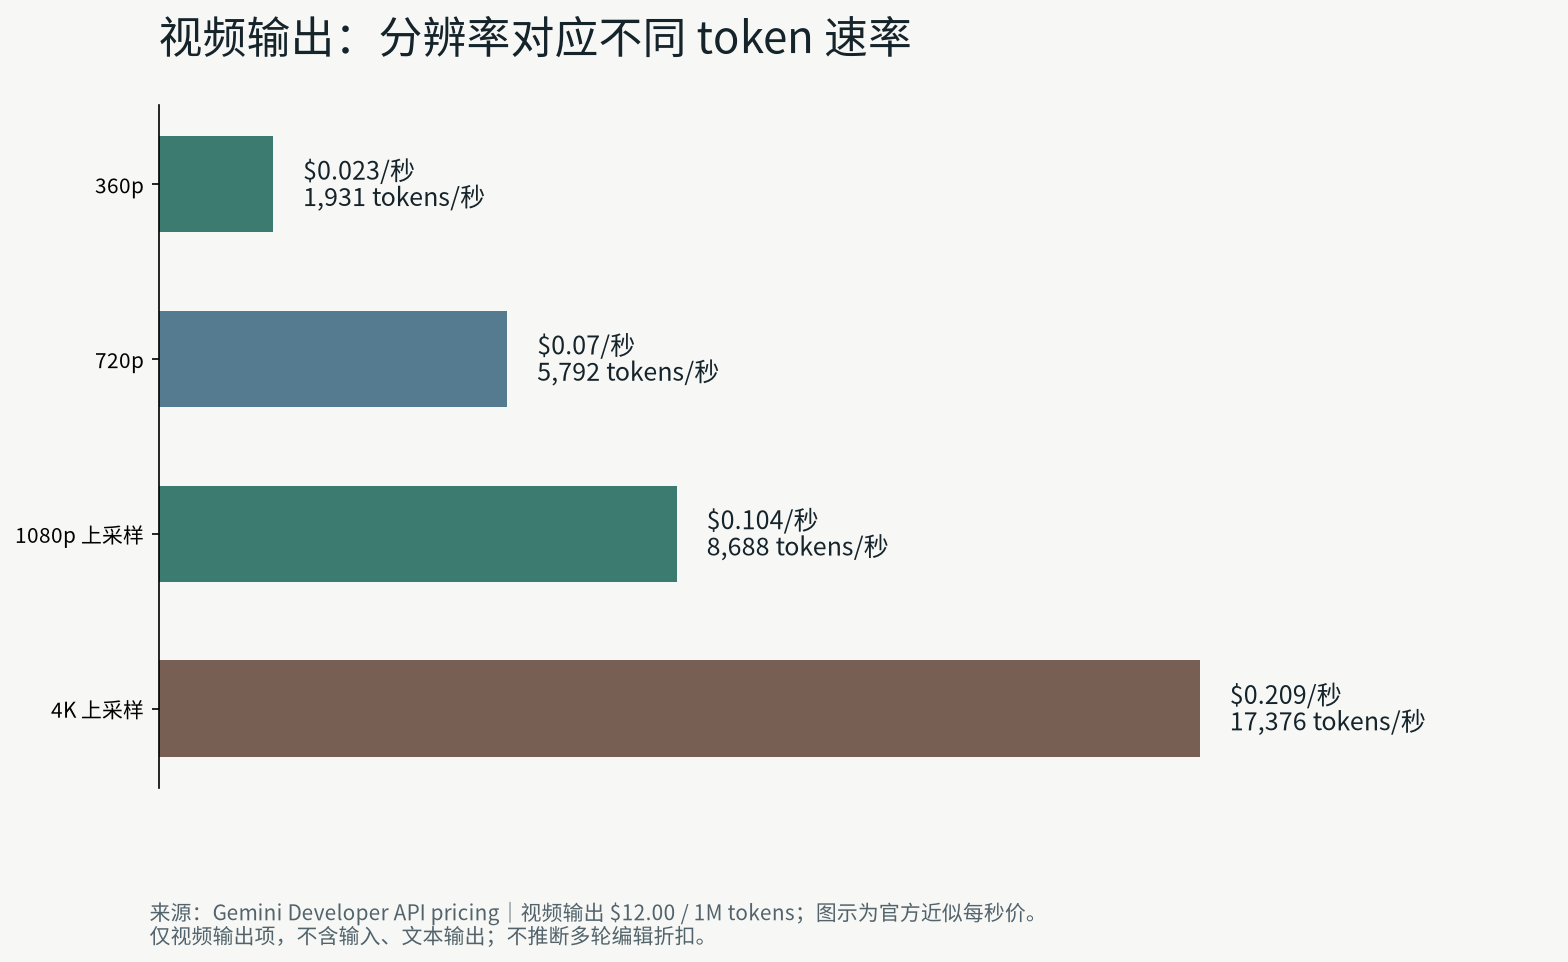
图注:依据 Gemini Developer API pricing 绘制;每秒价为官方近似值。1080p 与 4K 对应上采样,不代表相同生成路径,也不包含输入与文本输出。
图中较低分辨率适合讨论草稿预算,但不应据此宣布某种工作流必然省下多少。模型挑选、有效片段比例和实际编辑输出都会影响总账。多轮编辑是否有额外折扣、每类修改实际产生多少计费输出,锁定资料未查到可统一套用的规则,应以真实用量记录核对。
Cloud 博客称价格比前代降低 30%,其他分辨率也有类似节省。这里沿用官方降幅,不拿不同精度的单价再计算新的“精确比例”。定价页还写明,从 2026-12-03 起,gemini-omni-1.1-flash 请求会自动路由到新版并按新版计费;旧模型名也需要纳入迁移验收。
让改稿围绕同一条作品,但别预支省钱结论
发布建议是先用 360p 或 720p 快速出草稿,通过后续编辑修改细节,再将最好的创作放大到 1080p 或 4K。支持的对话式修改包括替换产品或背景、调整光照天气、改变画幅,覆盖完整 15 秒片段。
这给内容团队带来的价值,是可以把修改目标说得更局部:保留已经确认的角色和动作,只调整背景。它并不自动构成账单承诺。我建议每轮同时记录输入参考、要求保留的部分、需要改变的部分和返回用量,评审时先检查保留项是否漂移,再决定继续编辑还是重做。
尤其不要把“无需从头开始”的创作体验,解释成“后台只计算被改动的区域”。清单没有这样的计费保证。技术选型应看完成可用成片的整体过程,既包含成功修改,也包含失败后放弃的尝试;否则很容易低估实际生产成本。
用文本接口整理分镜,视频仍交给官方接口
下面通过 Twinkle Model 的 OpenAI 兼容聊天接口整理分镜和改稿指令,需安装 openai 并设置环境变量,模型名以模型广场实际上架名为准。示例只生成文本,不是一次成功的视频生成记录;视频生成仍走 Google 自己的 Gemini API,不据此声称中转已上架或透传 Omni 视频接口。
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://big-model.smart-agi.com/v1",
    api_key=os.environ["TWINKLE_API_KEY"],
)
response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{
        "role": "user",
        "content": (
            "为产品演示整理结构化分镜与改稿指令,只输出 JSON 文本。"
            "分字段写清主体、动作、背景、声音、保留项、修改项和验收条件。"
            "未提供的产品信息标为待确认,不补造卖点。"
            "本轮只把背景改成室内自然光环境,保留产品外观和动作。"
        ),
    }],
)
print(next(iter(response.choices)).message.content)
返回文本仍需应用解析和人工检查,不能把提示词要求输出结构化内容,等同于接口已经做过严格格式校验。这里刻意不写视频 SDK 方法和请求字段:锁定资料没有提供这些细节,未查到的协议不适合用猜测补齐。
验收表还应把创作要求与技术要求分开。前者检查产品外观、叙事和声音是否符合需求,后者核对实际时长、输出规格与用量记录。修改画幅之后,原先正确的构图未必继续成立;改变光照之后,产品颜色也需要重新确认。这些是建议的复核项目,不是本文已经完成的实测。
对于准备上线的应用,我会保留每轮提示词与参考素材的版本关系,让编辑人员能找到被认可的草稿。只保存最后的下载文件,很难解释为什么后续修改偏离了原定方向。多轮编辑的价值需要靠可回溯的创作记录兑现,而不是靠把所有尝试都称作成功。
产品赠额、API 价格与输出标记分别处理
Google Vids 博文写明,有 Google 账号或 Google Workspace 订阅的用户,每月可在 Vids 免费生成最多三条 15 秒视频。这是 Vids 产品内权益,不是 Gemini API 免费档,更不能从中扣减开发者的 API 账单。
Cloud 说明还注明输出带不可感知的 SynthID 水印。定价页付费档的产品改进使用标记为 No,但不能将其延伸解释为资料未给出的保存期限或其他数据承诺。
我的接入顺序会是:先确认账号能力与参考输入权限,再建立草稿和改稿记录,最后验证放大后的交付质量。把这些边界说清,比只在预算表里填入更低的每秒价格,更接近这次升级真正能改变的工作方式。
参考资料
- Google:Anish Nangia,Gemini Omni 1.2 Flash 发布介绍
- Google Cloud:John Nack,一般可用说明
- Gemini Developer API pricing
- Google Vids:产品内视频生成权益
- Google DeepMind:Gemini Omni 1.2 Flash 模型卡
作者说明:作者在运营 API 中转站 Twinkle Model(https://big-model.smart-agi.com):GPT 1折、国模1折、满血 Claude、源头中转、低价稳定,价格见模型广场 https://big-model.smart-agi.com/model-plaza。