真实工程开发的现场:通宵任务为什么总在半路停摆?
你给几个 Agent 分配好模块重构和单测编写的任务,满心欢喜准备让它们通宵跑完,第二天早上直接收割代码。
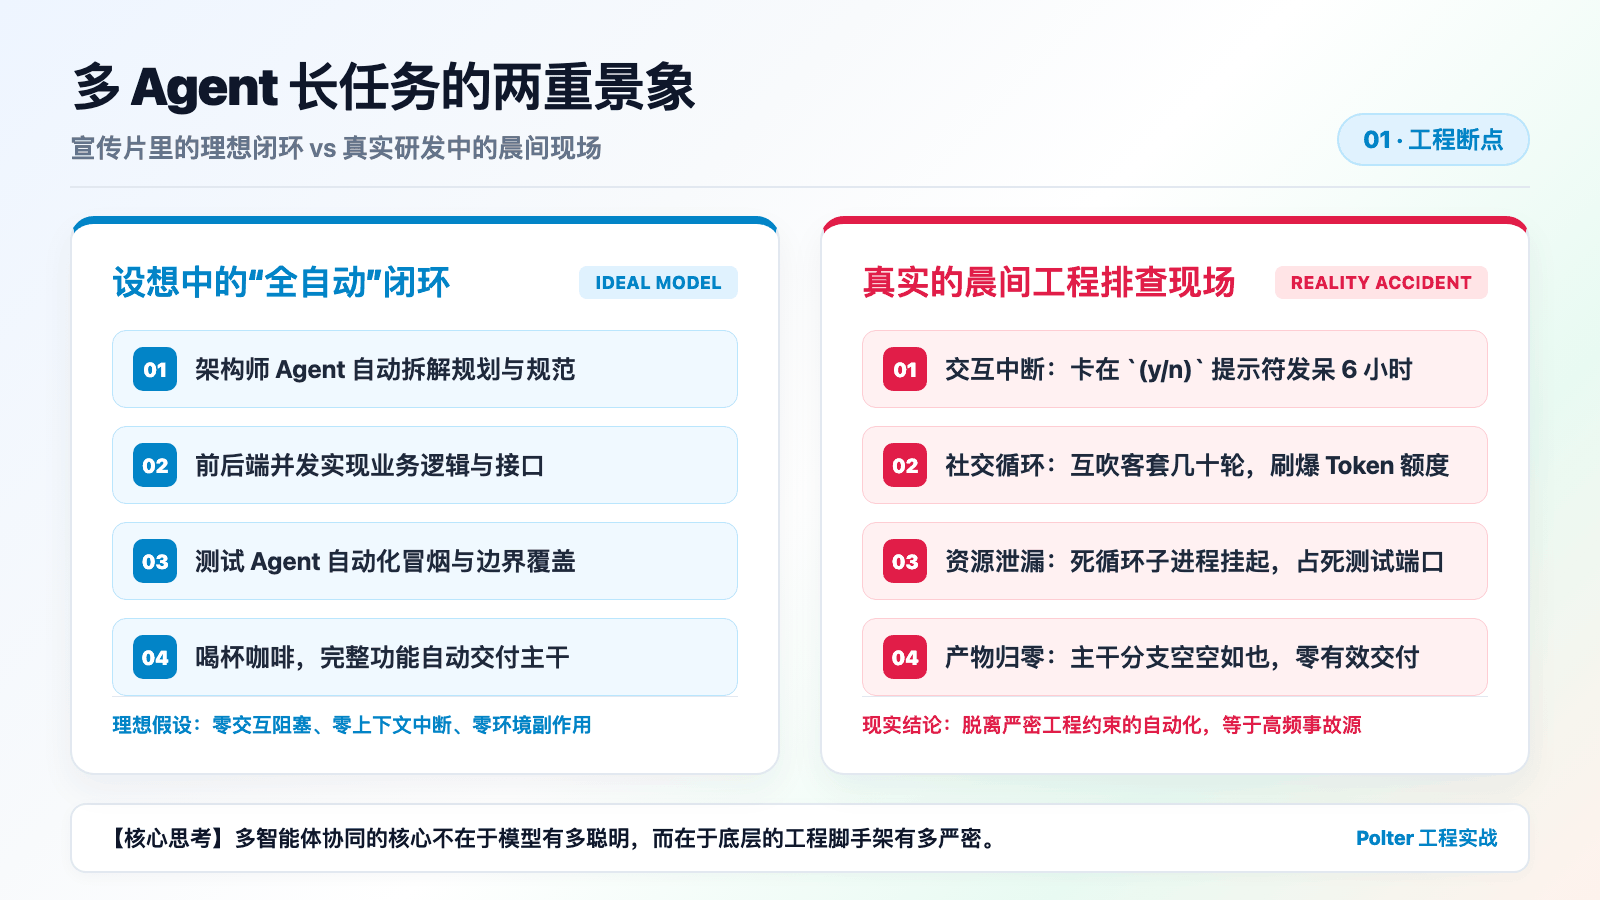
结果早上拉开终端,迎面撞上的不是交付的产物,而是一幕让人哭笑不得的翻车现场:
- 最中间的终端停在凌晨 1 点 14 分的一个依赖安装提示上,
Do you want to proceed? (y/n)的光标在一闪一闪——整个任务刚跑了 15 分钟就卡住了,后面整整发呆了 6 个小时; - 翻开另外两个所谓“协作 Agent”的交互日志,几十轮来回全在礼貌拉扯:“我认为你的重构建议很中肯”、“感谢补充,那我按这个思路修改”,当天的 API 额度刷得精光,实际代码一行没改;
- 还有一个终端跑单测时没设超时,一个死循环的子进程在后台无声地挂了一整夜,把测试端口牢牢占死;
- 主分支依然干干净净,没有哪怕一个通过验收的代码提交。
在很多人的设想中,多 Agent 协同就是把几个 CLI 工具拉起来,画一张流程图就能自动运转。但在真实的软件工程里,多智能体协同从来不是“让几个 AI 聚在一起聊天”,而是一场极度骨感的工程对抗:
交互阻断、通信死循环、Token 浪费、状态断片、单测虚假全绿、跨平台环境跑崩。
想让多 Agent 真正承接长达数小时的工程长任务,必须先拆掉以下这 6 个致命深坑。
01|不能由人当网管:单一总管架构与精准自动化代答
在终端里做多任务开发,最容易犯的错误就是“平铺窗口”:左边起一个写业务,中间起一个写测试,右边起一个查文档。你以为自己是指挥三军的大将军。
只要跑过 15 分钟,你的身份就会发生残酷的转变——你根本不是什么指挥官,你成了全天候驻场的人肉网管:
- 这个 Agent 跑两步停下来问:
我想要执行 npm install,是否允许?(y/n); - 那个 Agent 刚改完一行代码又弹窗:
需要读取这个配置项,是否授权?; - 另一个终端刚跑完构建,又在等你敲回车继续。
一个终端问你,你觉得严谨;三个终端同时问,你开始手忙脚乱;五个终端一起跑,你的屏幕就像早高峰红绿灯全部失灵的十字路口。你根本来不及细看每一条具体改了什么,最后只能一路闭着眼睛狂按 y。
更致命的是:人是要睡觉的。
深夜 1 点 10 分,某个 Agent 抛出一个依赖确认提示,整个小队立刻就地停摆,白白发呆一整夜。
工程解法:单总管(Supervisor)对口与精准代答
在 Polter 的架构中,人与系统的对接界面被严格收拢:人类只对接一个总管(Supervisor)。
任务怎么拆解、派给哪个角色、中途如何流转、产物如何验收,由总管统一负责。
- 终端状态与意图边界感知:Polter 监控每个 Worker 终端的运行状态与控制台输出。当检测到某个 Worker 卡在确认弹窗或标准输入提示符上时,总管会结合当前任务的既定目标进行意图判定;
- 常规操作精准代答:如果是工单范围内的常规操作(如拉取已声明依赖、执行本地构建、读写任务工作区文件),总管通过底层代答机制(
terminal_answer_prompt)安全放行,绝不让终端在深夜无谓发呆; - 高危红线人工唤醒:只有当 Worker 尝试执行超出任务边界的危险动作(如删除未声明的外部文件、推送远端分支、暴露敏感配置),或者遇到总管无法决断的选择时,总管才会主动触发用户通知(
notify_user),把工程师从被窝里叫醒。
工程铁律:如果一个协同系统每隔三分钟就要人类敲一次回车,它就不是自动化,而是高频人机打卡机。
02|千万别建平权群聊:丢掉客套,回归层级命令与任务频道隔离
初次尝试多 Agent 协同的人,脑子里往往有一个极具理想主义的构想:
“建一个大群,把架构师、前端、后端、测试拉进同一个群聊里,让他们自由讨论,碰撞出思想的火花!”
千万别这么干。在真实生产环境里,平权群聊是烧光 Token 和摧毁交付效率的第一杀手。把几个大模型连进一个对等的消息网络,往往会出现这三幕荒诞剧:
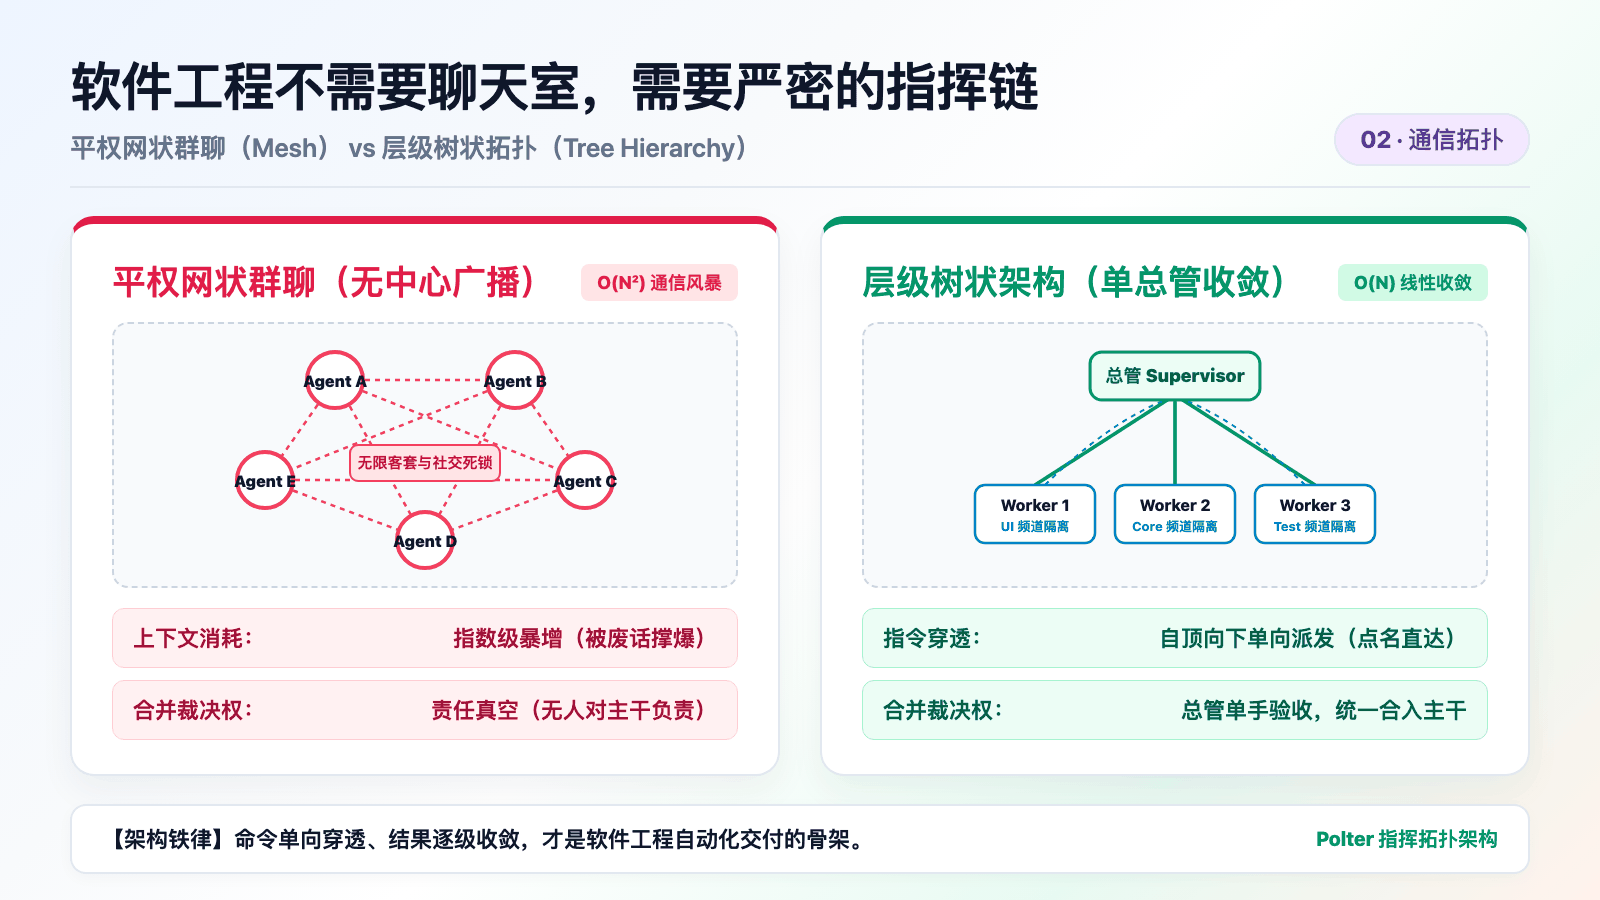
- 通信复杂度 $O(n^2)$:5 个 Agent 的群聊,只要有一个发言,另外 4 个都要被唤醒并吞下上下文。几轮讨论下来,通信量呈指数级暴增;
- 无休止的“商业互吹”:大模型有一种天然的反思与讨好倾向。前端 Agent 刚发了一段代码,后端 Agent 就会回一句:“方案非常棒!但我有一点微小的建议……”前端 Agent 立刻礼貌回复:“非常感谢您的深刻洞察,我马上调整……”大家礼貌拉扯了几十个回合,上百万上下文窗口全被废话填满,正事一行没动;
- 责任真空:群里每个人都在提建议,真到代码跑崩的时候,大家都觉得自己“只是提了个建议”,没有任何一个角色对“代码能否合并进主干”承担最终裁决权。
工程解法:严密的树状命令链与频道隔离
军队打仗和工厂流水线从不开全员闲聊大会。工程交付需要的是明确的指挥链条,而不是自由散漫的沙龙:
- 自顶向下的单向指令:只有总管能够向特定 Worker 下发指令(Mention 直达)。Worker 之间默认不可互相打扰,甚至感知不到其他 Worker 的日常碎语,根本没有互相搭讪的机会;
- 自底向上的单向交付:Worker 完成阶段任务或遇到无法解开的阻塞,只向总管提交结果数据或调用
task_progress报障,禁止跨级跑去教其他 Worker 怎么写代码; - 工单级频道物理隔离(Channel Isolation):每个具体任务分配独立的讨论频道。哪怕在同一个项目组内,改界面的日志与输出绝不流入写后端接口的 Worker 上下文。
工程铁律:让 AI 聚在大群里各抒己见,是烧光算力预算最快的方法;命令单向穿透、结果逐级收敛,才是软件交付的骨架。
03|抛弃复杂通信协议:磁盘持久化看板 + Git Worktree 物理隔离
很多团队编排多 Agent 时,沉迷于设计极其复杂的协同协议:长达几十层的嵌套 JSON-RPC、复杂的握手时序图、在内存里跑分布式状态机。
然而,大模型是有概率发生幻觉的,终端会因网络或系统原因重启,超长任务的上下文窗口更是必然会遇到压缩与截断。
当一个重构任务连续跑了 3 个小时、涉及几十个文件,上下文不得不做内存压缩(Compact),或者总管终端意外重启了——你指望 Agent 靠自己的聊天记忆回忆起“刚才改到了哪一步、还有谁没测完”?
它要么当场失忆从头再跑一遍,要么记忆漂移,把刚刚写完的核心模块误当成没做完的代码直接覆盖掉。
工程解法:外置持久化 Task 看板与物理代码隔离
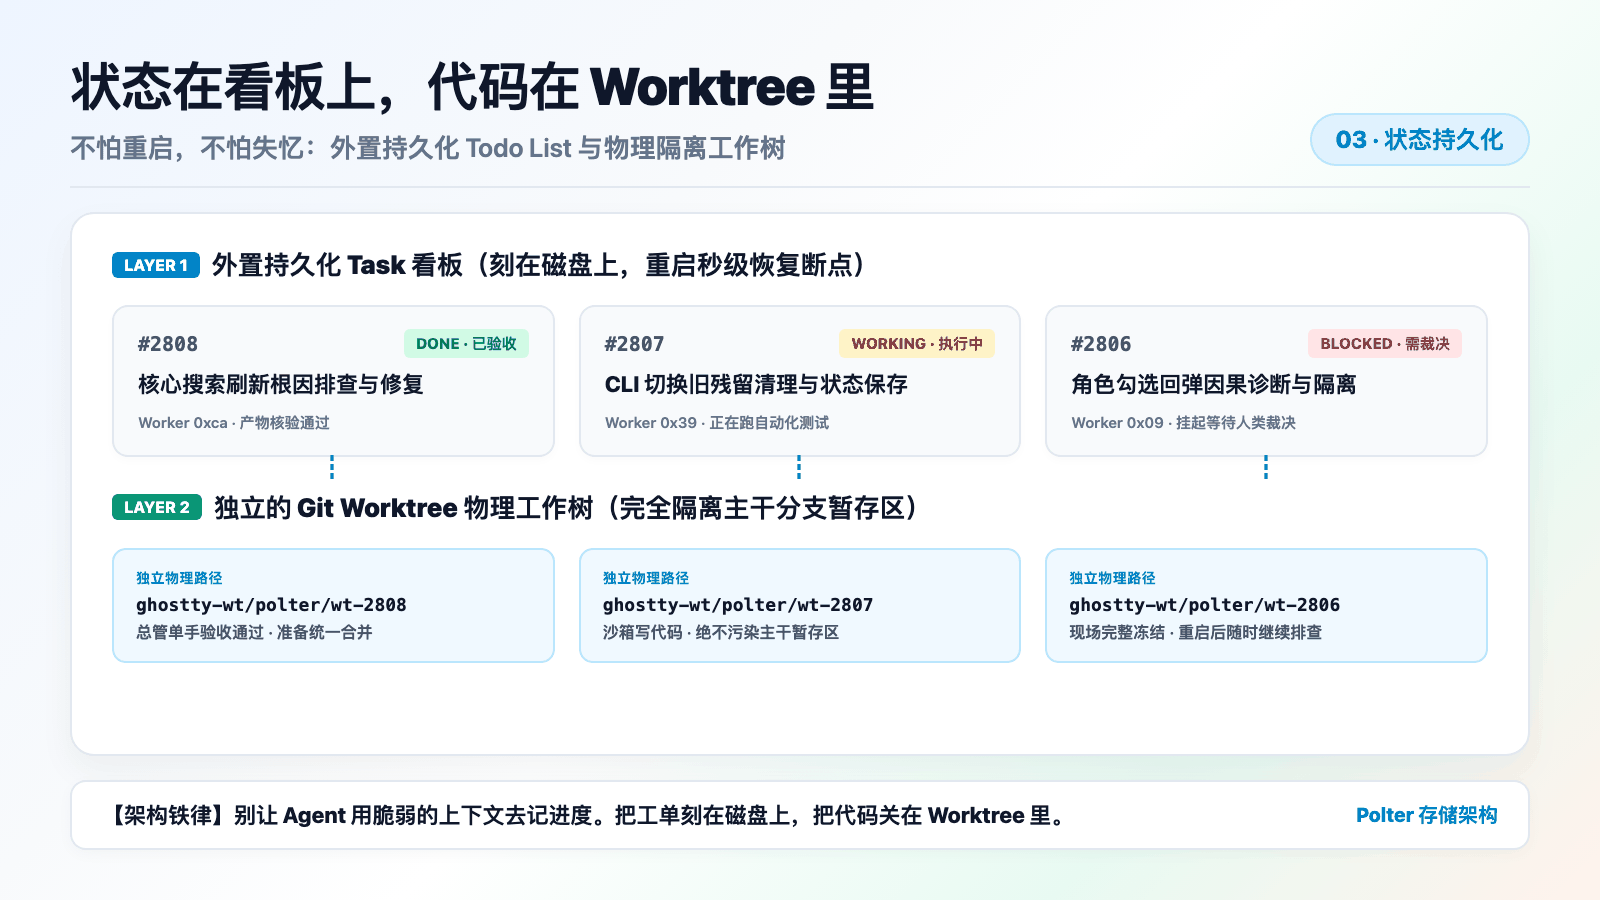
与其在 Prompt 里反复哀求 AI“千万别忘”,不如给它们一个小学生都能看懂的 Todo List(任务看板),把状态固化在任何一方崩溃都丢不掉的物理磁盘上:
- 任务看板刻在磁盘上:协同状态不依赖任何 Agent 的聊天记忆,而是维护在一个外置持久化 Task 面板上。每个工单只有最明确的核心元数据:
Task ID、Title、Kind(Feature / Bug / Research / Other);State(Open / Closed / Cancelled);Progress(Queued / Working / Blocked / Done)。
- 状态即断点:不管是总管还是 Worker,无论中途经历多少次重启或上下文清空,只要调一次
task_list,扫一眼看板,秒级就能接上进度断点; - 代码物理隔离(Git Worktree):每个工单在创建时,强制绑定一个独立的 Git Worktree。改业务逻辑的 Worker 在专属的工作树目录改,做性能探针的在探针目录跑。各个 Worker 在物理磁盘上完全隔离,谁也碰不到主干分支的暂存区;
- 单手验收与合并:Worker 完成后仅提交验收物并标记
done;总管拉起真实环境比对通过后,由总管统一单手执行 Commit 与 Merge,随后调用task_close自动归档并回收 Worktree。
工程铁律:别让 Agent 用脆弱的上下文去记进度。把工单刻在磁盘上,把代码关在 Worktree 里,系统才能随时重启、永不断片。
04|拒绝全家桶膨胀与算力浪费:角色按需定制与模型成本分层
很多团队刚搭建好多 Agent,恨不得给每一个角色都配上最顶级的模型,再把能搜刮到的所有 MCP 工具、上万行的业务说明和几十个技能文档一股脑全塞进提示词。
这在工程质量和运行成本上,带来了双重的荒唐:
1. 上下文污染(Context Pollution)
这就像要求一个体育老师,每天去操场上课前,都必须先把语文、数学、物理、化学的全套课件和备课笔记死记硬背一遍塞满脑子。但实际上他这堂课只需要带大家跑个 800 米,那些沉重的教案不仅一次都用不上,反而把他的注意力和体力消耗殆尽。
大模型的有效注意力资源极其宝贵。给一个负责写单元测试的 Worker 塞满数据库迁移脚本、UI 设计规范和部署指南,它在写代码的时候,注意力被各种无关指令疯狂拉扯,写出的代码拖泥带水,极易产生逻辑幻觉。
2. “杀鸡用牛刀”带来的成本灾难
这就像花大价钱请来了一位米其林主厨,却每天按顶级的时薪让他通宵蹲在后厨水池边刷盘子。
顶级推理模型的单价是极度高昂的。让顶级模型去跑机械的语法检查、修改类型声明、搬砖写重复的 CRUD,一晚上跑下来几十上百美元就蒸发了。
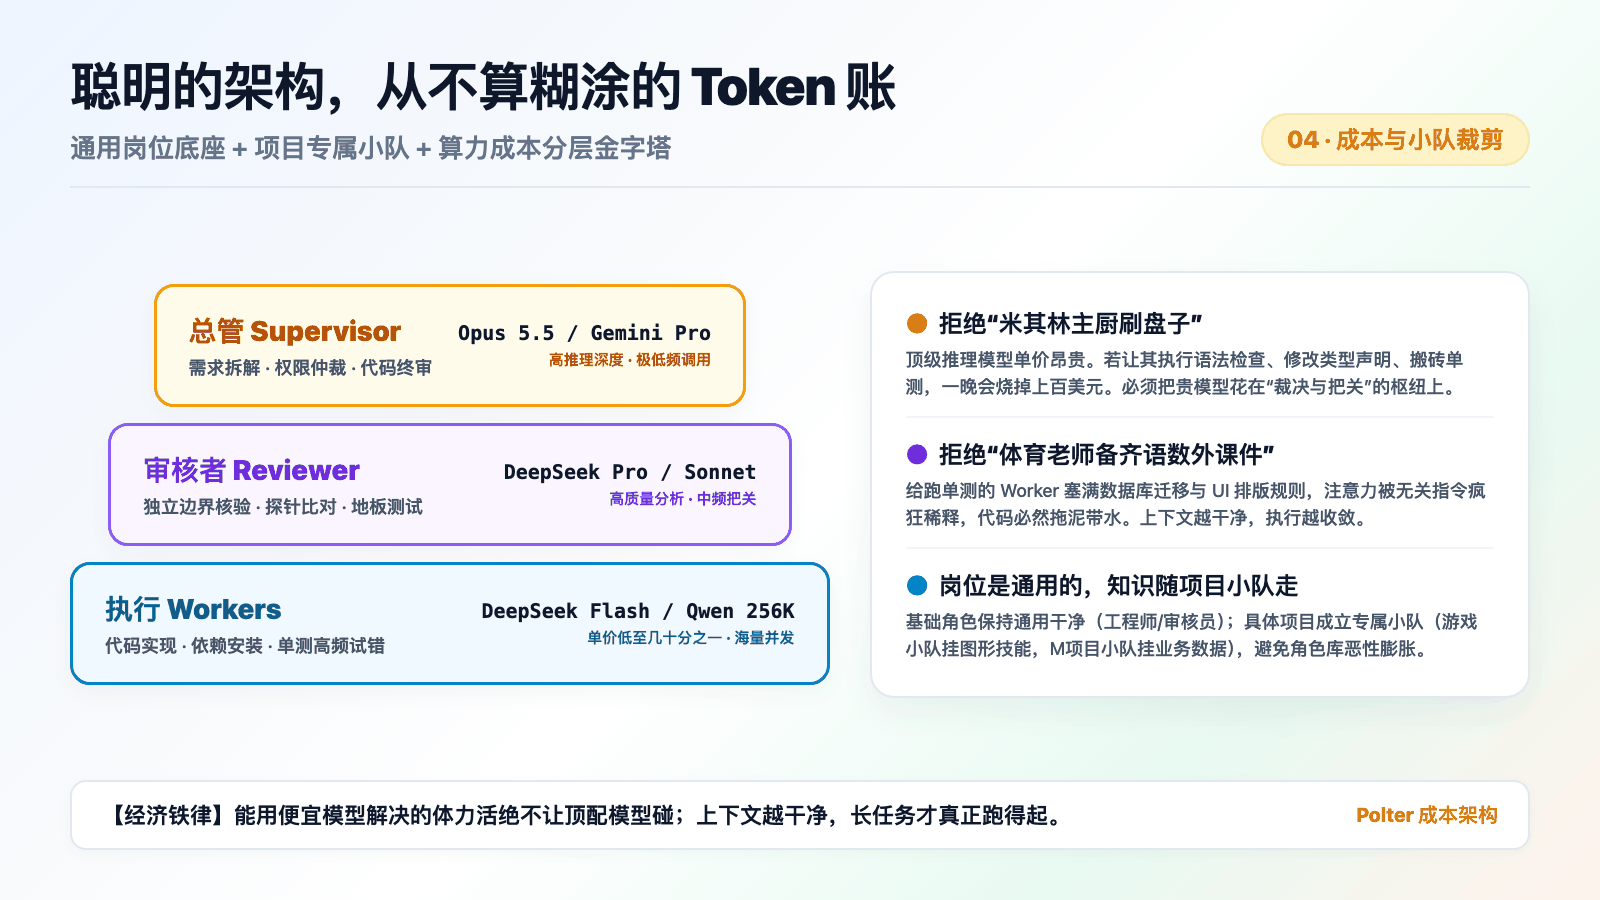
工程解法:通用岗位底座 + 项目专属小队 + 模型成本分层
在成熟的多 Agent 落地架构中,必须把**“通用岗位”和“项目小队”**彻底拆解清楚:
- 基础角色就是“通用岗位”:
就像一家公司里的“软件工程师、测试员、审核员、设计师”一样,系统底层只定义最通用的岗位底座。岗位本身是通用的、干净的,绝不绑定任何特定业务的冗杂知识; - 小队就是“具体业务项目的作战单元”:
当面对具体的业务项目时,不是去生造新岗位,而是组建一个专属的“项目小队”:- 如果是负责游戏开发的 A 小队,小队里的工程师就会统一注入游戏引擎规范、图形渲染工具以及游戏专属的技能包(Skills);
- 如果是负责公司核心业务 M 项目的 B 小队,小队里的工程师就会挂载 M 项目专属的业务背景、数据库架构、内部接口文档与特定的 MCP 服务;
- 岗位是通用的,知识和技能是随项目小队走的。这样既避免了为每一个新需求生造出“游戏开发角色”、“M项目开发角色”等一堆混乱膨胀的专用角色,又保证了每个小队的成员脑子里只有本项目的上下文,绝不被隔壁项目的无关知识所污染;
- 严格的模型成本分层(算清这笔 Token 账):
- 大脑统筹(总管负责需求拆解与代码终审):配置高推理深度的大模型(如 Claude Copilot Opus 5.5 或顶阶推理模型),负责理解人类的模糊需求、拆解边界、仲裁代码质量。高智力模型当指挥官,把钱花在刀刃上;
- 日常搬砖(执行者负责具体实现与单测):配置极速、单价极低的高性价比模型(如 DeepSeek v4.1 Flash、DeepSeek v4 Pro 或本地 256K 局部上下文的轻量模型)。其单价只有顶级模型的几十分之一,即便为了跑通一个边缘测试反复重试几十次,成本也只有几毛钱。
05|必须在物理层约束资源:给 Agent 套上 CPU/内存的“紧箍咒”
大模型调用的确在云端,但 Agent 在本地执行的任务却是货真价实的本地进程:拉取代码、安装依赖、编译构建、跑测试流水线。
大模型本质上是一个不可预测的代码生成器。如果没有对本地衍生进程的硬性控制,AI Agent 真的会在本地“发疯”:
- 某个 Worker 自行编写了一段带并发死循环的测试脚本,启动了几百个未加限制的本地进程,直接耗尽系统的进程配额;
- 某个 Worker 尝试读取包含大量构建产物的目录,一次性把几个 GB 的无用数据全部往本地 Node 进程内存里拽,直接触发堆内存溢出崩溃(OOM);
- 某个自动化任务异常中断,但启动的后台服务与测试 Runner 进程没有被妥善回收,几十个孤儿进程持续占用监听端口,导致后续构建全线报
EADDRINUSE错误。
如果不给终端执行环境套上紧箍咒,本地开发机随时会被异常脚本搅得一团糟。
工程解法:终端级资源配额(Terminal Limits)与看门狗回收
在系统底层,必须给每一个 Worker 终端接上“限流阀”:
- 硬性资源限制:通过系统底层的资源配额接口(如 cgroups 或系统级进程限制),为每个 Worker 终端划定明确的 CPU 最大占用率与物理内存安全阈值;
- 超限自动拦截:当 Worker 衍生进程的内存使用陡增、触碰危险红线时,看门狗机制立即挂起异常进程并向总管上报错误,坚决不让单个异常脚本拖崩整机环境;
- 顺藤摸瓜彻底清理:工单关闭或取消时,由环境顺藤摸瓜将该任务派生出的整棵进程树、端口占用、环境变量与临时工作目录一并彻底物理销毁,绝不留任何孤儿进程在后台偷跑资源。
工程铁律:没有本地资源沙箱的多 Agent 系统,就是在开发机上裸奔。
06|测试绝不能纸上谈兵:跨系统真机验证,才是一切交付的终点
大模型在编程时有一个最致命的弱点:它极度擅长在代码里“自欺欺人”。
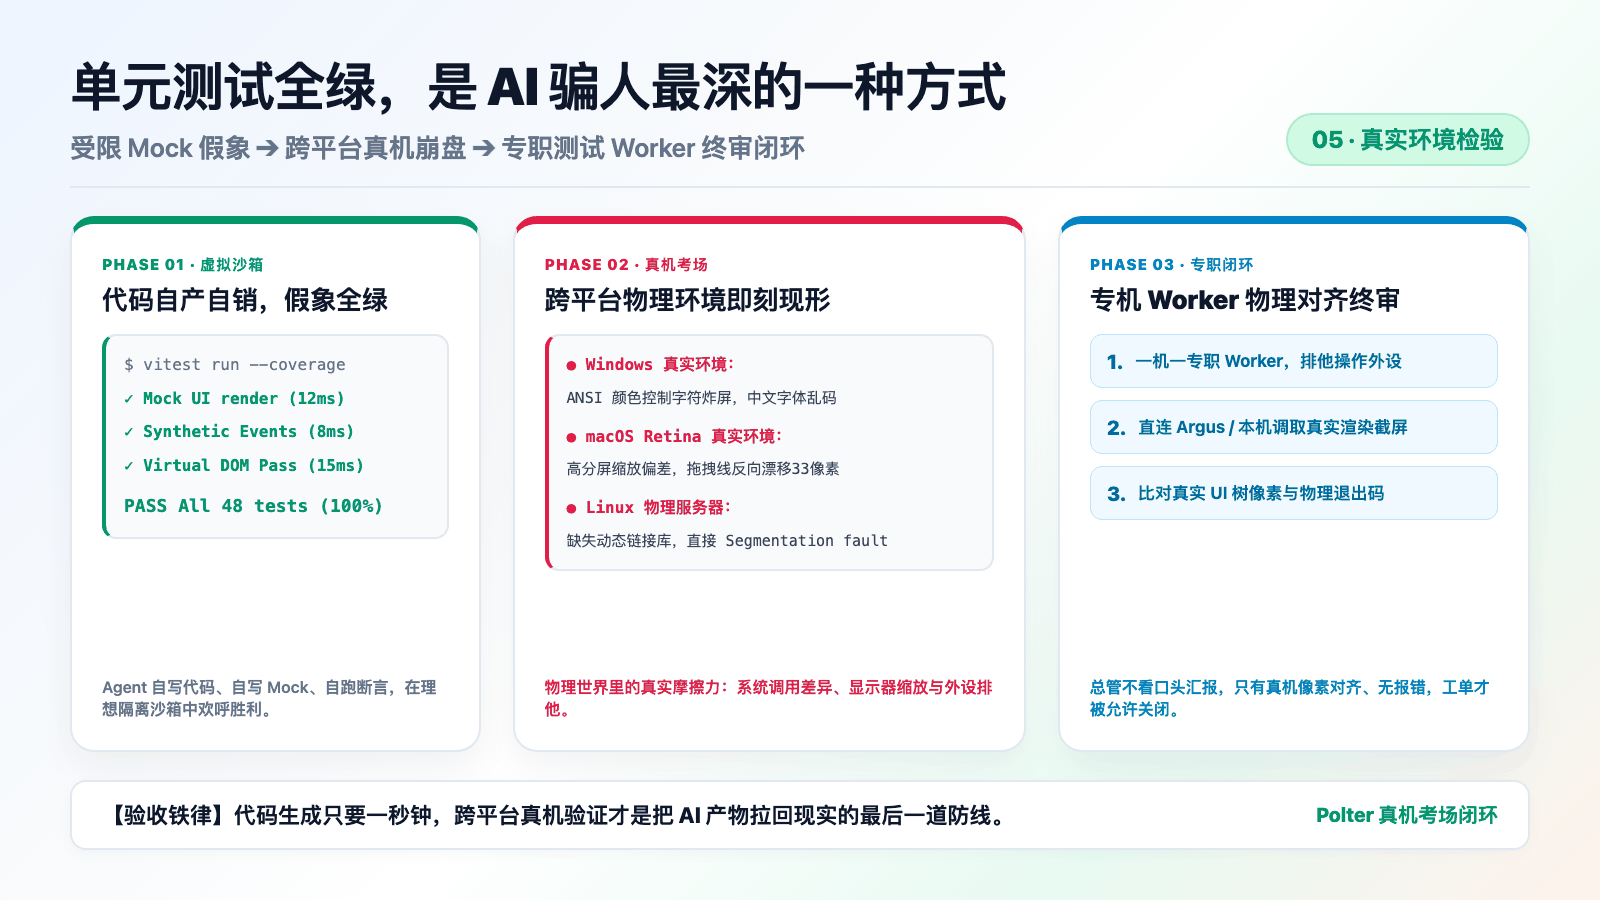
你给它一个跨平台的开发需求,它自己写实现、自己 Mock 数据、自己跑本地单测,两秒钟后兴奋地弹出一行大字:All 48 tests passed! 所有的单测全部通过!。
你满怀欣喜地把产物打成安装包放到真实系统上一跑,现实会再次给你上课:
- 丢到 Windows 上,控制台全成了乱码,ANSI 颜色逃逸字符炸了一屏;
- 丢到 macOS Retina 高分屏上一看,由于缩放计算偏差,拖拽分界线直接反向漂移了数十个像素;
- 丢到 Linux 服务器上,直接抛出系统动态链接库缺失的段错误(Segmentation Fault)。
代码在 Mock 环境里单测全绿,和在真实用户的物理设备上跑通,中间隔着十万八千里。如果多 Agent 系统的闭环止步于“控制台里单测全绿”,交出来的产物大概率依然是一堆无法落地的半成品。
工程解法:专职真机 Worker,不听口头汇报只看物理像素
在真实的工程闭环中,交付标准必须向真实物理环境看齐:
- 一机一专职 Worker,严禁并发踩踏:真实设备的鼠标、键盘焦点与剪贴板是排他的。macOS 走本地环境验证,Windows 通过专职通道(如 Argus 协议)直连物理机驱动。绝不允许两个 Worker 同时往一台物理设备上派发自动化动作;
- 像素级与语义 UI 树比对:总管不会听信 Worker 口头汇报的“我已经修好了”。总管调取真机截屏与系统 UI 树,核验真实渲染边缘、排版间距与命令退出码。只有在物理环境下真实跑顺、像素对齐了,这个工单才允许被真正关闭。
工程铁律:代码生成只要一秒钟,物理世界的摩擦力却有成百上千步。真实的跨平台真机验证,是把 AI 产物拉回工程现实的最后一道防线。
总结:从概念玩具走向生产流水线
回顾多 Agent 在实际工程开发中的探索,最核心的结论只有一句话:
多智能体协同的门槛,从来不在于大模型有多聪明,而在于底层的工程制度有多严密。
当你在幻想几只 AI 靠着“灵性”为你全自动交付软件时,底层的每一个现实细节都在试图摧毁你的任务:通信风暴、上下文失忆、权限卡死、算力爆仓、虚假测试。
唯有建立起严密的工程约束:
- 一个集中拍板的总管,终结人工值班网管;
- 一条单向穿透的指挥链,斩断无休止的平权寒暄;
- 一张刻在磁盘上的持久看板,让任务不怕重启与失忆;
- 一套算力分层的 Squad 矩阵,让高性价比模型去干搬砖脏活;
- 一条不可逾越的物理资源红线,防止失控进程与端口泄漏;
- 以及一处毫不留情的跨平台真机考场,确保每一行代码真实落地。
把这些脚手架搭结实了,多 Agent 才会从屏幕上互相客套的实验玩具,真正蜕变成那支可以通宵作战、为你稳定交付高质量代码的工程精锐。
💬 【互动讨论】
你在用 AI 写代码或尝试多 Agent 工具时,遇到过哪些让你哭笑不得的“翻车事故”?是半夜卡死、Token 烧爆,还是被一行假单测骗惨了?欢迎在评论区分享你的踩坑血泪史,我们一起排雷!