短版摘要(供短帖渠道使用) 10 月 30 日,商汤在 Hugging Face 开源了 SenseNova-Loop-9B-Preview(Apache 2.0)。它把第 4–27 层这 24 层当成一个循环块,用同一份权重连跑两遍:只存 32 层权重(约 9B 参数),每次前向却做 56 次层计算,官方称推理等效约 14.6B 参数。循环段里还用了双流 mHC(流形约束超连接,Sinkhorn 迭代 20 次)稳住残差流。官方自测在几个 Agent 类基准上超过 Qwen3.5-27B。本文讲清它的结构、代价(计算和 KV 缓存都按约 1.75 倍走)、适合什么场景,以及怎么用 OpenAI 兼容接口把它和云端大模型组合起来。
这两年开源模型的主线是 MoE:总参数做大,每个 token 只激活一小部分,用“存得多、算得少”换能力。
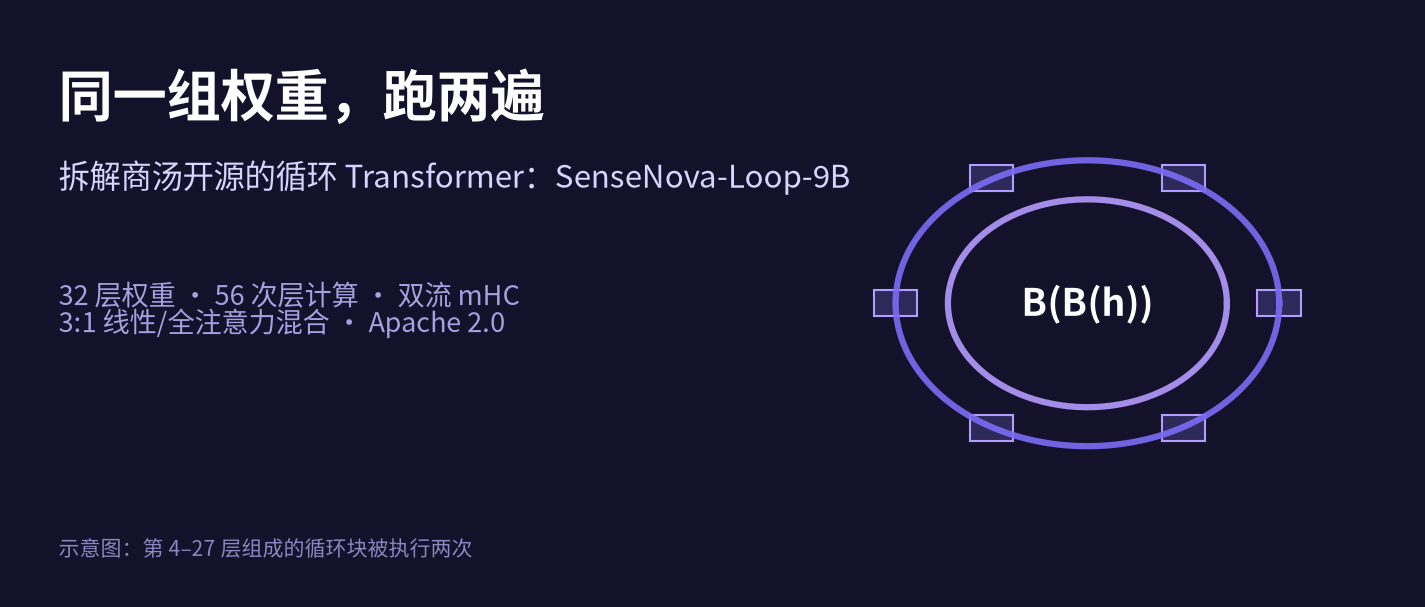
商汤这次放出来的 SenseNova-Loop-9B-Preview 走的是反方向:存得少、算得多。同一段网络让 token 走两遍,用额外的计算换“更深”的模型,而不是更多的参数。
我把模型卡和仓库里的 modeling_sensenova_loop.py 都读了一遍。下面讲它到底怎么循环、mHC 起什么作用、代价在哪,以及我认为它适合放在系统的哪个位置。
一、结构:32 层权重,56 次层计算
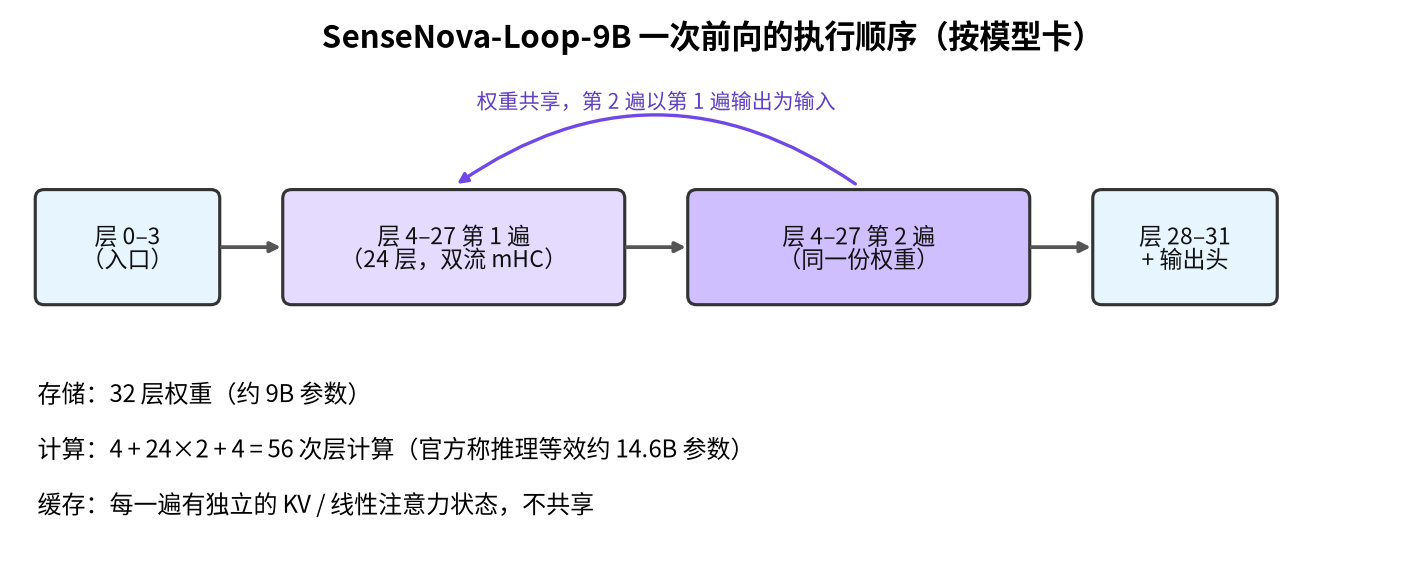
模型卡写得很直接,整条前向路径是这样的:
- 先过第 0–3 层;
- 第 4–27 层(共 24 层)组成一个循环块 B,用同一份权重执行两次,写成公式就是
B(B(h)),第二遍的输入是第一遍的输出; - 最后过第 28–31 层和输出头。
所以一次前向是 4 + 24×2 + 4 = 56 次层计算,但磁盘和显存里只存 32 层权重。官方给的规格是“约 9B 总参数、约 14.6B 推理参数”,后者就是把循环展开之后的等效规模。
另外几个关键配置:
| 配置 | 值 |
|---|---|
| 隐藏维度 / FFN 维度 | 4096 / 12288 |
| 词表 | 248,320 |
| 全注意力头 / KV 头 | 16 / 4 |
| 注意力布局 | 每 4 层 = 3 层线性注意力 + 1 层全注意力 |
| 训练最长序列 | 262,144 tokens |
| 输入 / 输出 | 文本 + 图片 / 文本 |
注意一个细节:循环边界(第 4 层和第 28 层)正好对齐完整的四层组,所以“3 线性 + 1 全注意力”的节奏在两遍里都保持不变。这不是巧合,而是为了让长上下文下的显存和速度特性在循环里依然可预期。
二、为什么要加 mHC:循环最怕残差流失控
循环 Transformer 并不是新想法,Universal Transformer 一类工作很早就试过权重共享的深度递归。难点在于训练稳定性:同一组变换反复作用在残差上,信号很容易被放大或衰减。
SenseNova-Loop 在循环段里用的是 mHC(Manifold-Constrained Hyper-Connections,流形约束超连接)。它来自论文《mHC: Manifold-Constrained Hyper-Connections》(arXiv 2512.24880)。思路分两步理解:
- **Hyper-Connections(HC)**把原来单条残差流扩成多条,层之间可以学习怎么读、怎么混、怎么写回,表达力更强;但论文指出,这会破坏残差连接原本的“恒等映射”性质,导致训练不稳、难以放大。
- mHC 的修补办法是:把负责混合多条流的矩阵,用 Sinkhorn-Knopp 算法投影到“双随机矩阵”(每行每列和都为 1)上。这样混合就变成输入特征的凸组合,均值守恒、范数受控;而双随机矩阵相乘仍是双随机矩阵,所以层数叠多了也不会把信号放飞。
对循环模型来说,这一点尤其关键:第二遍等于把同一段网络又乘了一次,如果每层的混合矩阵本身是“守恒”的,那么循环两遍也守恒。这是我理解它选择 mHC 的核心原因。
仓库里的实现可以印证这些细节。Sinkhorn 归一化就是在 log 空间里交替做行、列归一:
def sinkhorn(logits, iterations):
    """Normalize routing logits across rows and columns in log space."""
    logits = logits.float()
    for _ in range(iterations):
        logits = logits - torch.logsumexp(logits, dim=-1, keepdim=True)
        logits = logits - torch.logsumexp(logits, dim=-2, keepdim=True)
    return logits.exp()
(摘自官方 modeling_sensenova_loop.py,配置为 2 条流、20 次迭代。)
还有两个工程上值得注意的点:
- 路由参数强制保持 FP32。代码里专门重写了
_apply,即使整模型转成 BF16,mHC 路由器的权重也保留 FP32。社区做的 NVFP4 量化版也特意说明“mHC 路由参数和 Sinkhorn 计算保持 FP32,不动”。如果你要自己做量化,这部分别一起压。 - mHC 区间不能跨越循环边界,代码里有显式校验(
MHC cannot cross a Loop phase boundary)。也就是说,“循环几遍、从哪层到哪层、路由参数”都属于 checkpoint 的执行配置,推理框架必须原样复现,不能当普通 32 层模型加载。
三、效果:官方自测,先看着
据 DailyCited 对官方发布的整理,商汤称 Loop-9B 在 WorkBuddy Bench、RaccoonPPT Bench、AutomationBench 上超过 Qwen3.5-27B;消融里 mHC 在 GPQA Diamond 上带来 4.42 分、在 TeamBench 上带来 13.34 分的提升。
这些都是厂商自己的基准,而且前三个偏办公和自动化场景,技术报告目前还写着 TBD。我的态度是:结构上的思路值得认真看,分数先打个问号,等第三方评测或技术报告出来再下结论。
四、代价:权重省了,计算和 KV 缓存没省
“9B 参数、27B 级效果”听起来像白捡,但循环是有账要算的:
- 每 token 的层计算量是 56/32 = 1.75 倍。和一个不循环的 32 层模型比,权重读取不变(同一份权重读两次,可能命中缓存,也可能不会),但 FLOPs 实打实多了 75%。
- KV 缓存同样变多。代码注释写得很清楚:“autoregressive cache states are independent per visit”,每一遍都有自己的 KV 和线性注意力状态。按“每 4 层 1 层全注意力”推算:入口段 1 层、循环块 6 层 × 2 遍、出口段 1 层,一共 14 份全注意力 KV,而不循环的 32 层只有 8 份,也是 1.75 倍。
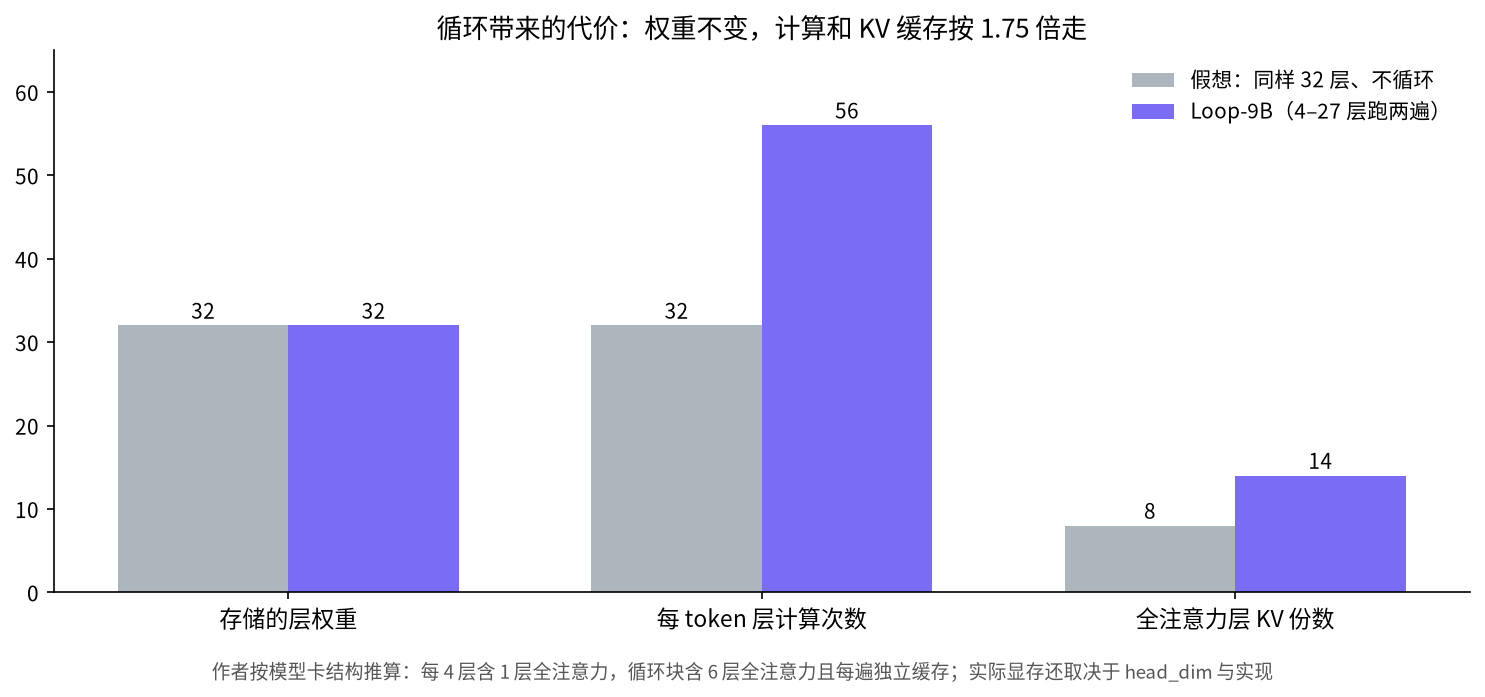
(上图是我按模型卡结构做的推算,不是官方数据;实际显存还取决于 head_dim 和框架实现。)
好在 4 个 KV 头的 GQA 和 3 的线性注意力已经把长上下文的 KV 压得比较低,1.75 倍是在一个较小的基数上乘。真正的结论是:它省的是显存里的权重和下载体积,不省算力。显存紧、算力相对富余的场景(单卡部署、端侧、多实例并发)更受益;如果你的瓶颈本来就是 GPU 算力,循环反而是负担。加速方面,模型卡写着 MTP(多 token 预测)已可用,DSpark 和 DFlash2 两种投机解码草稿模型还在训练中。
五、怎么用:自托管 + 云端大模型组合
官方给了 LightLLM 和 SGLang 两种部署方式,都会暴露 OpenAI 兼容的 /v1/chat/completions。以 LightLLM 为例(4 卡,路径换成你自己的):
docker run --rm --gpus all --ipc=host -p 8000:8000 \
  -v /path/to/SenseNova-Loop-9B-Preview:/model \
  ghcr.io/modeltc/lightllm:main \
  python -m lightllm.server.api_server \
    --model_dir /model --model_name SenseNova-Loop-9B-Preview \
    --tp 4 --host 0.0.0.0 --port 8000
我更推荐的用法不是让它“包打天下”,而是把它当 Agent 流水线里的便宜一档:文档解析、表格抽取、工具调用前的结构化判断交给自托管的 Loop-9B,真正需要强推理或写长代码的步骤再交给云端旗舰模型。两边都是 OpenAI 兼容接口,路由层可以写得很薄:
from openai import OpenAI

BACKENDS = {
    # 本地自托管的 Loop-9B(LightLLM / SGLang)
    "local": dict(client=OpenAI(base_url="http://localhost:8000/v1", api_key="none"),
                  model="SenseNova-Loop-9B-Preview"),
    # 云端旗舰模型,示例用 Twinkle Model 的 OpenAI 兼容网关,换成官方地址同样可用
    "hosted": dict(client=OpenAI(base_url="https://big-model.smart-agi.com/v1",
                                 api_key="YOUR_KEY"),
                   model="gpt-6.1-terra"),
}

CHEAP_TASKS = {"extract", "classify", "route", "summarize_doc"}

def run(task_type: str, messages: list[dict], **kw):
    tier = "local" if task_type in CHEAP_TASKS else "hosted"
    b = BACKENDS[tier]
    try:
        r = b["client"].chat.completions.create(model=b["model"], messages=messages, **kw)
        return tier, r.choices[0].message.content
    except Exception:
        # 本地实例忙或挂掉时降级到云端,保证流水线不中断
        if tier == "local":
            h = BACKENDS["hosted"]
            r = h["client"].chat.completions.create(model=h["model"], messages=messages, **kw)
            return "hosted-fallback", r.choices[0].message.content
        raise
几个落地提醒:
- 用 Transformers 直接跑需要
trust_remote_code=True,官方验证环境是 Transformers 5.18.0 + PyTorch 2.11.0 + CUDA 13.0;SGLang 目前要用还没合入主干的 PR 分支,生产环境先等合并。 - 想关掉思考模式,
apply_chat_template时传enable_thinking=False;做结构化抽取时建议关掉,省 token 也更稳定。 - 评估时别只看“答对率”,要同时测 每秒 token 数和每请求显存。循环模型的优势和劣势都在这两项上。
六、我的看法
SenseNova-Loop 真正有意思的地方不在某个分数,而在于它把“深度”和“参数量”拆开了:循环次数成了一个可以单独调的维度。从代码看,配置格式里有 counts 和 probabilities 两个字段,加载时会校验“只支持固定次数的循环 checkpoint”。我的猜测是,格式本身为“多种循环次数按概率采样”留了余地,只是这个 Preview 固定跑两遍。如果后续版本能做到推理时按难度动态决定循环几遍,那就是在架构层面实现“简单问题少想、难问题多想”,这比在提示词里调 reasoning effort 要底层得多。
在那之前,它是一个显存友好、算力不省的 9B 多模态模型,适合放在 Agent 流水线里做便宜而可靠的那一层。
参考来源
- Hugging Face 模型卡,sensenova/SenseNova-Loop-9B-Preview:https://huggingface.co/sensenova/SenseNova-Loop-9B-Preview
- 官方实现 modeling_sensenova_loop.py:https://huggingface.co/sensenova/SenseNova-Loop-9B-Preview/blob/74194bb88a5c916d557d4d028c28e05ea601be9b/modeling\_sensenova\_loop.py
- 社区 NVFP4 量化版说明:https://huggingface.co/gitcommit90/SenseNova-Loop-9B-Preview-NVFP4
- mHC: Manifold-Constrained Hyper-Connections(arXiv 2512.24880):https://arxiv.org/html/2512.24880v1
- DailyCited,Today in AI · Oct 31(官方发布与基准整理):https://dailycited.com/d/2026-10-31/
作者说明:我在运营一个 API 中转站 Twinkle Model(https://big-model.smart-agi.com),源头中转:GPT 1折、国产模型 1折、满血 Claude,主打低价、稳定。文中的网关地址只是示例,用官方接口或自建服务同样适用。各模型价格见模型广场:https://big-model.smart-agi.com/model-plaza 。