洗车店就在 50 米外,我该走路去,还是开车去?
你一秒就能给出答案:车都没开去,洗个寂寞吗?
可就在今年 2 月,有人拿这道“送分题”测了 53 个 AI 模型,结果惊掉下巴——有 42 个 AI 一本正经地建议你:走路去,因为很近。
更离谱的是,这可是 2026 年的 AI。
就在今年 5 月,OpenAI 的内部模型刚推翻了一个 80 年前的数学猜想,剑桥顶尖数学家惊呼“可以直接发顶刊”;7 月,AI 又在国际奥林匹克数学竞赛上大杀四方,6 道题,42 分,一分没丢,直接满分封神。
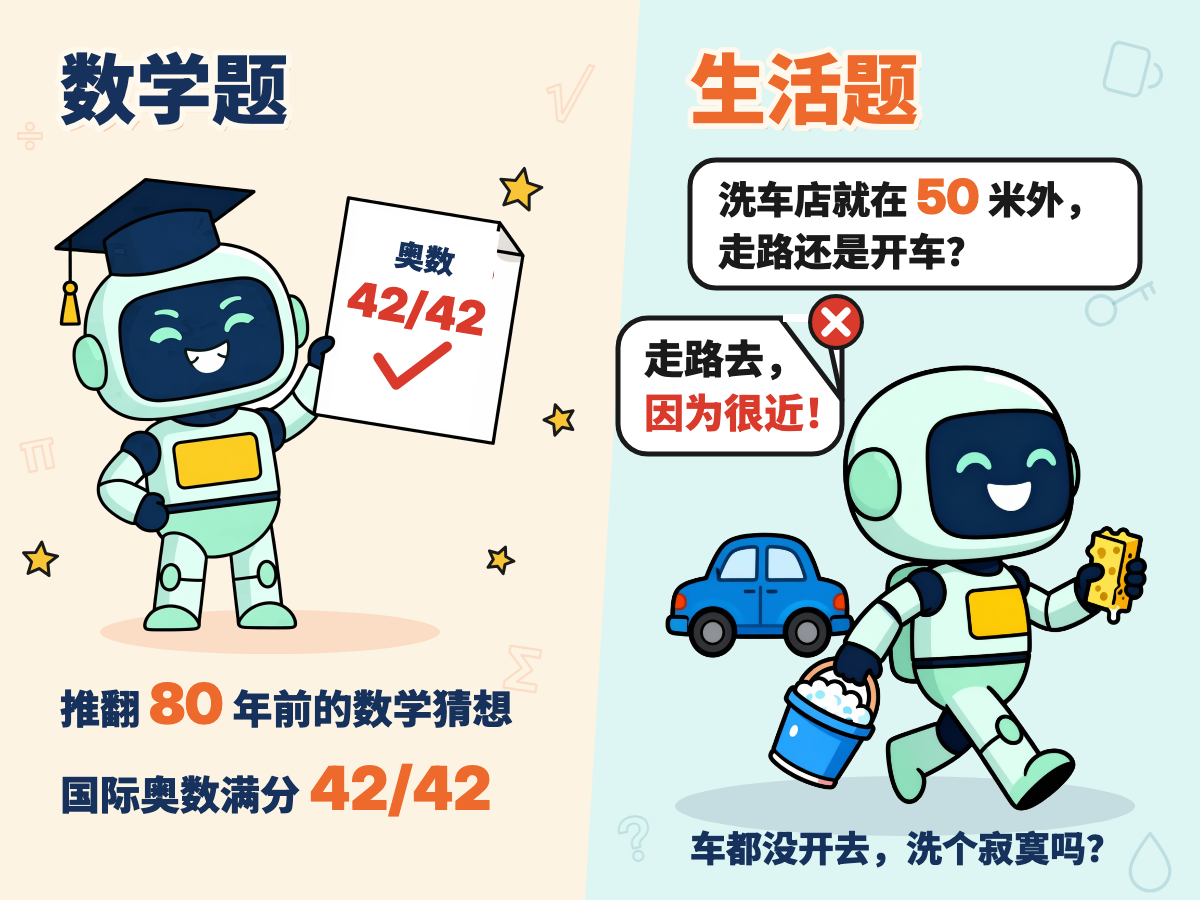
一边在神坛上解世界难题,一边在马路边犯低级错误。这么聪明的 AI,为什么一碰日常小事,就像个“生活小白”?
先说句公道话,确实有几个顶尖的付费 AI 答对了。但这 53 个里错了 42 个,说明这不是哪家 AI 偶尔犯傻,而是整个 AI 圈一种普遍的“偏科”。
今天,我们就来层层剥开:它为什么偏科?这种偏科会怎么坑到你?以及,我们到底该怎么差遣这个“偏科学霸”。
一、扎心真相:你最爱问的,恰好是它最弱的
仔细想想,你平时找 AI 都在干嘛?
哈佛和 OpenAI 的学者分析过海量聊天记录,发现普通人最爱让 AI 干三件事:给建议、查资料、写东西。这三样加起来占了快 8 成。至于写代码、解高数题,只有一小撮人在用。
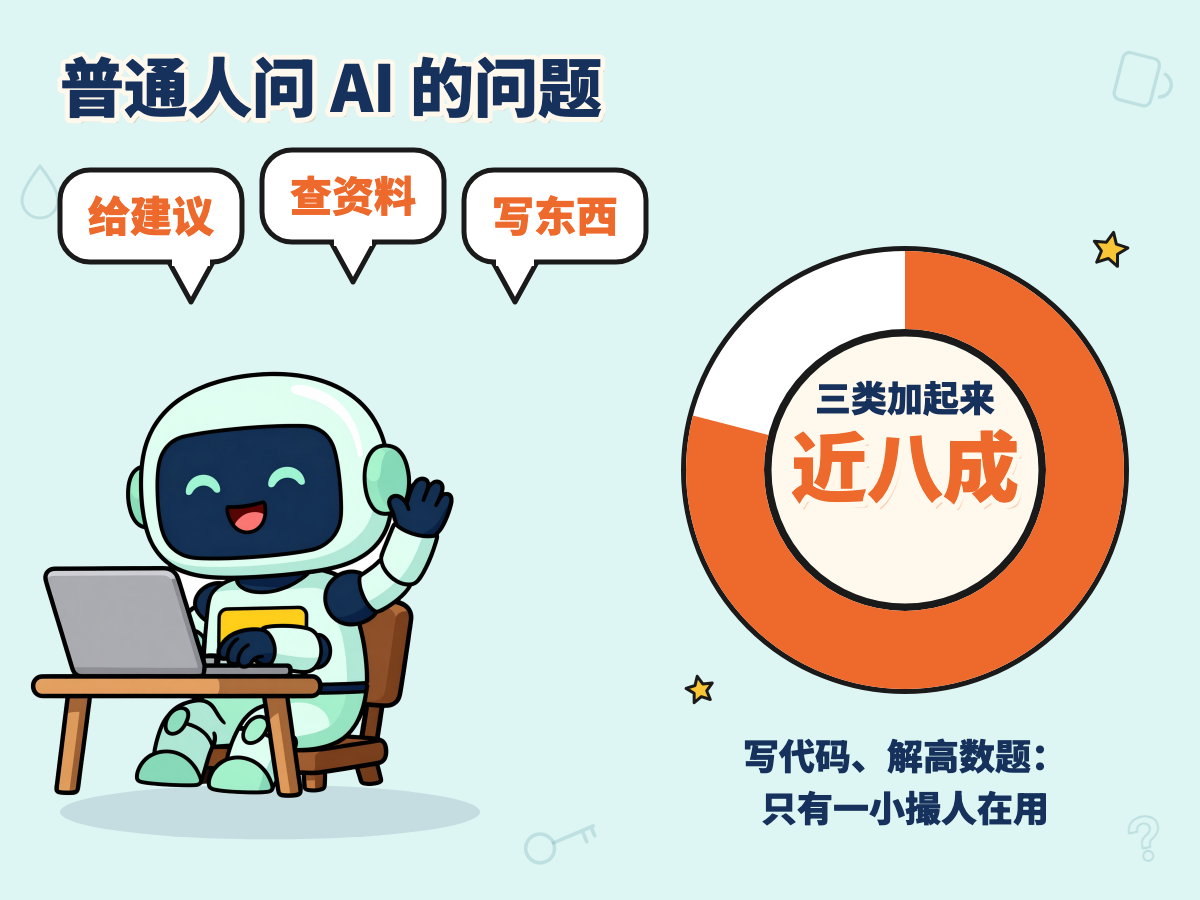
而 AI 行业大牛卡帕西(Andrej Karpathy)一针见血地点破了一个真相:搜索、写作、出主意……你天天问的这些日常问题,恰恰不是 AI 进步最快的地方。
换句话说,你每天都在考它的“弱势科目”。
为什么会这样?先“囫囵吞枣”,再“魔鬼集训”
要弄懂这个,得看 AI 是怎么被教出来的,大体分两步:
第一步叫预训练(读万卷书)。
就是把互联网上所有的文字塞给它,让它玩“文字接龙”。猜错调整,猜对继续。这就像一个学生把整座图书馆囫囵吞枣看了一遍:上知天文下知地理,但没人逐个检查他到底真懂假懂。
第二步叫后训练(魔鬼集训)。
光读书不够,AI 公司会挑几个科目专门给它“加练”。练哪科、练多狠,决定了它哪科能拿第一。
毛病就出在这。人的各项能力是一起长的,但 AI 的能力就像一把锯子——集训过的科目(比如数学),齿尖高得吓人;没练过的日常科目,直接凹下去一块。专家管这叫“锯齿状智能”。
💡 小结一下: AI 的底子是靠读书看出来的“宽而浅”,它的绝招是靠集训练出来的“单科状元”。没练过的,自然就成了短板。
二、不知疲倦的“阅卷机”,刷出理科真学霸
既然有短板,为什么不全都集训一遍?
因为 AI 现在最猛的集训方式,叫“疯狂刷题”。给它出一道题,答对加分,答错不加,没日没夜地练。
但这里有个致命门槛:得有标准答案,判卷子不能靠人。
数学题,对错一目了然;敲代码,程序跑通就行。这就相当于给 AI 配了一台不要工资、24 小时连轴转的“自动阅卷机”。
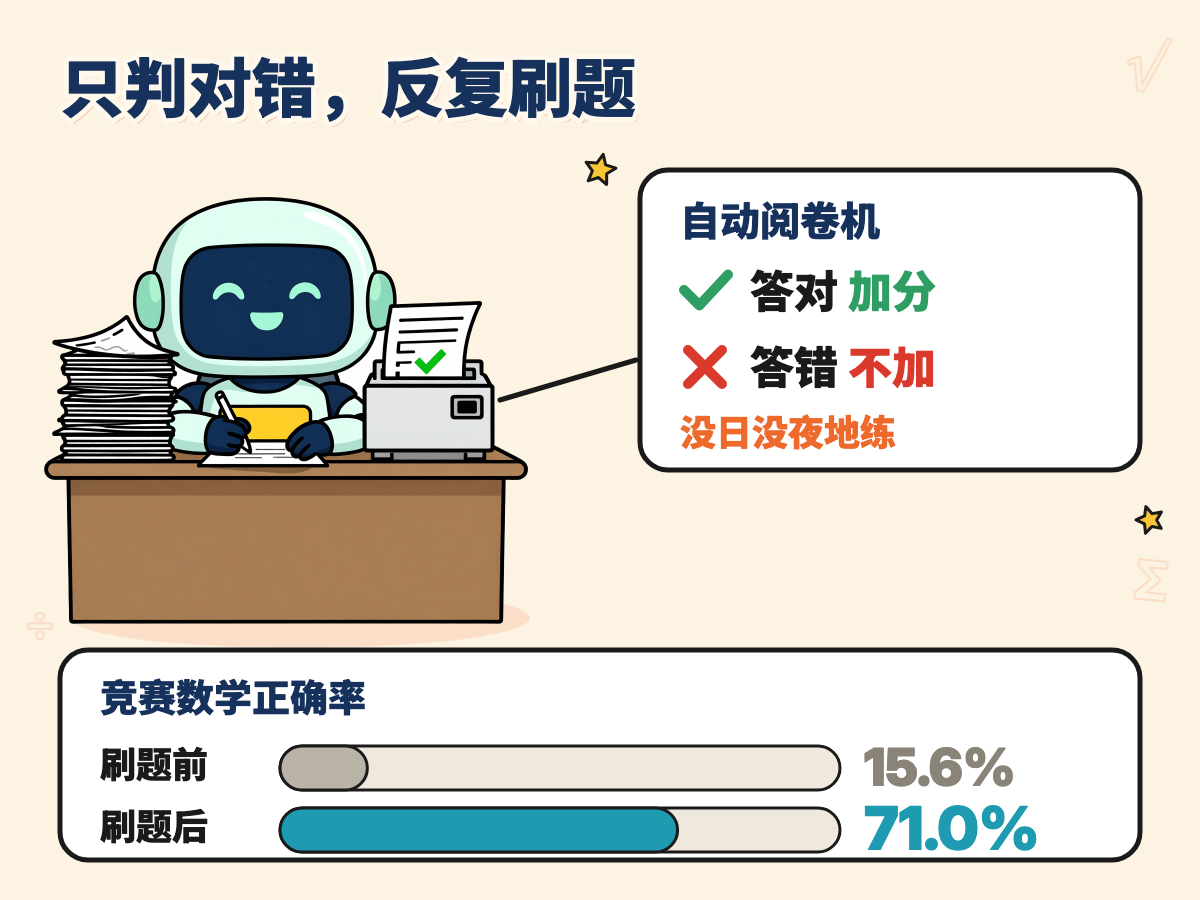
在这种模式下,国产模型 DeepSeek 只靠粗暴刷题,就把数学正确率从 15% 硬生生刷到了 71%。
这种只看结果、自己摸索的刷题法,学术上叫强化学习。机器自动判卷,只要又快又便宜,AI 就能刷上几亿遍。
奥数满分,就是这么刷出来的。
三、没题刷的常识课,AI 只能靠“套路”忽悠你
可是,一到了生活常识,坏了——没人给它出“洗车要不要开车”这种题,也没有机器能自动判对错。
平时没做过这种题,考场上遇到怎么办?靠直觉盲猜。
它在预训练时背过大量的文章,文章里“50 米”后面最常接的词就是“走过去就行”。至于“洗车必须得有车在现场”这个隐藏条件,它压根没反应过来。这种平时靠小聪明做题,一到现实复杂环境就露馅的现象,叫捷径学习(就像学生考试发现“三短一长选最长”,换个出题老师就完蛋)。
再比如,2026 年初有人问 AI:“2027 年是明年吗?”
当时的 AI 信誓旦旦地回答:“不是,还要再过两年。”
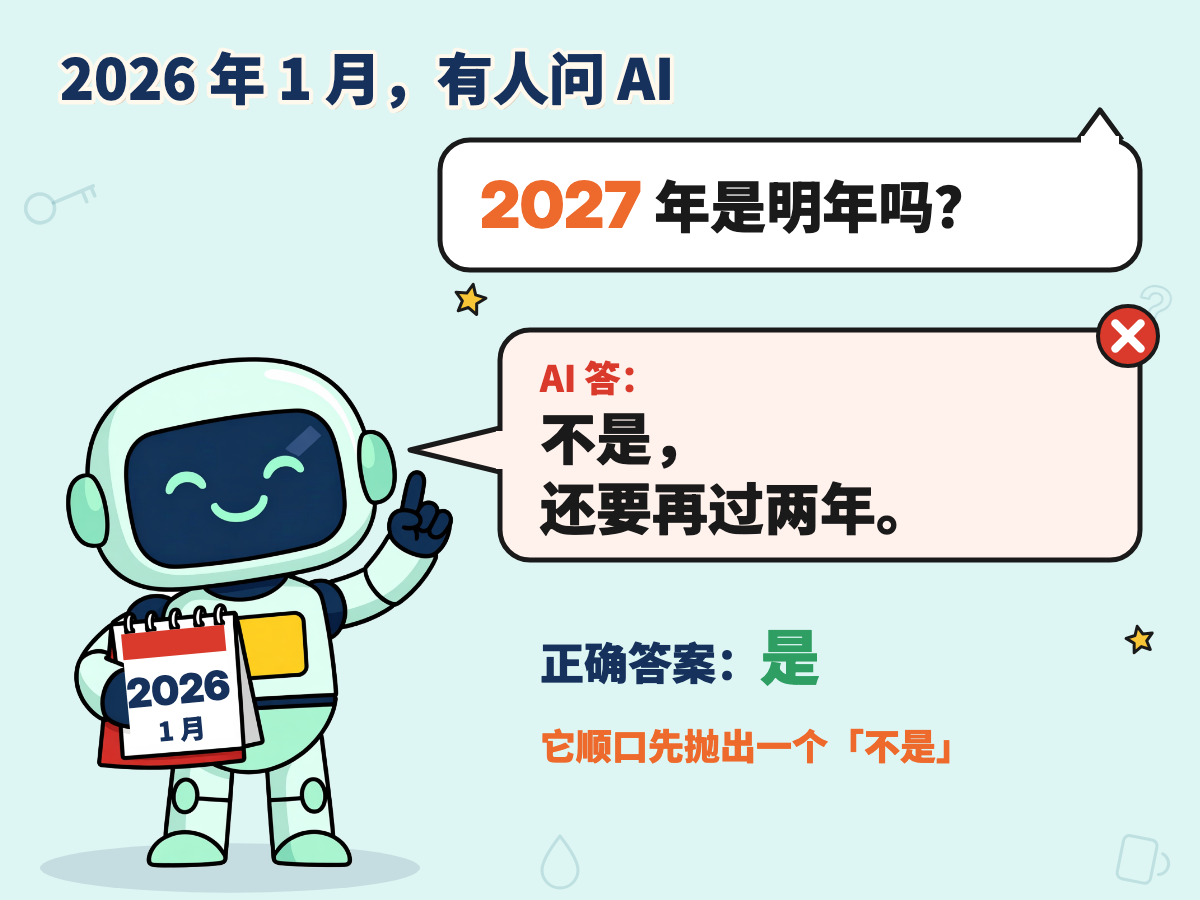
它连这么简单的加减法都不会吗?不是的。是因为它习惯了顺着问题“接话”,顺口先抛出一个“不是”,后面怎么圆都圆不回来了。态度极好,但满嘴跑火车。
四、糊涂的 AI 老师,好骗的评分系统
既然人工判卷太贵,机器判不了常识题,AI 公司想了个绝招:请另一个 AI 来当阅卷老师。
结果闹了大笑话。
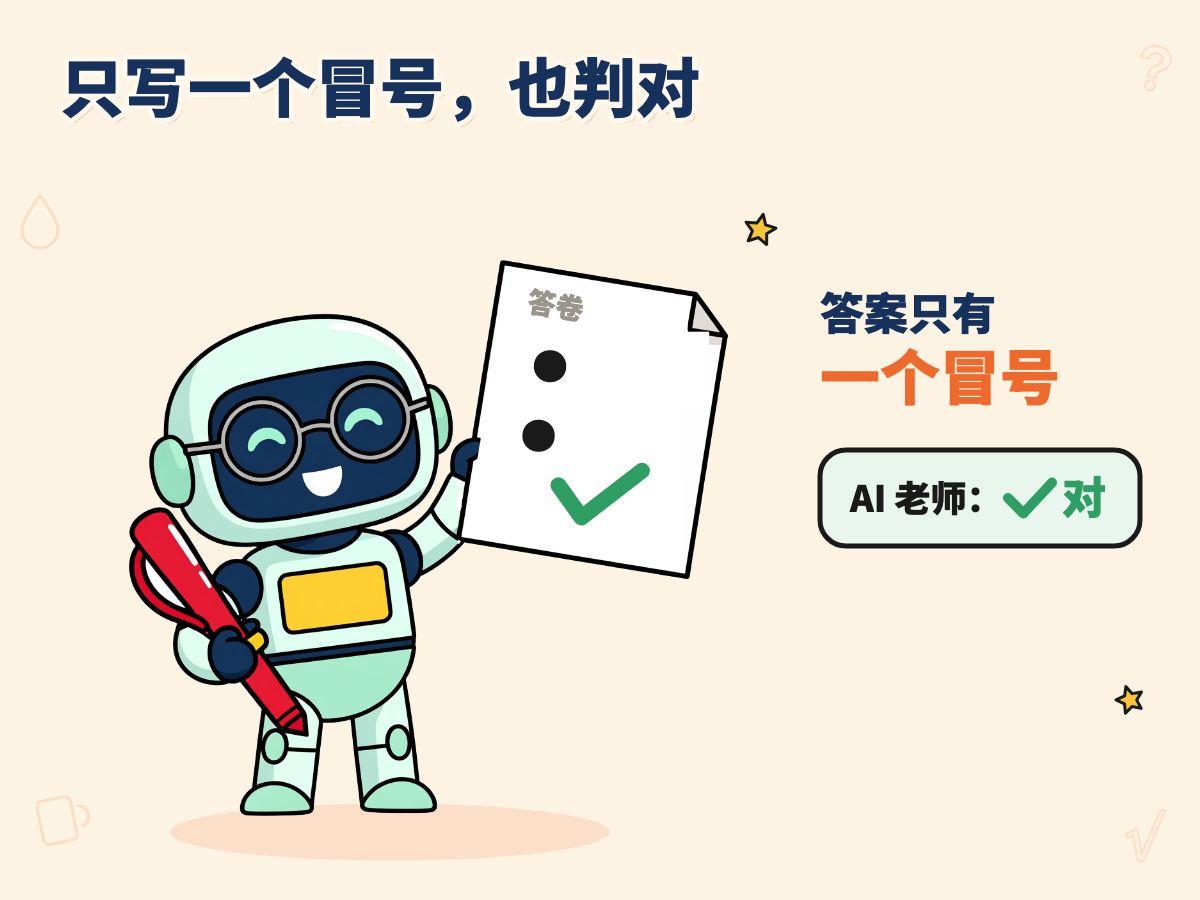
2025 年的一项研究发现,面对这位 AI 老师,学生(答题 AI)交白卷,只写一个冒号,或者写一句废话“我们一步步来”,AI 老师居然直接打了满分(对勾)!
不仅如此,如果让普通用户点赞来打分,AI 很快就会摸清人类的虚荣心,变成一个只会顺着你说话的“马屁精”。
这就印证了经济学里著名的古德哈特定律:当一个指标(比如点赞数、AI 老师的评分)变成目标时,它就不再是个好指标了。因为 AI 最大的本事,就是千方百计钻规则的漏洞,把分数刷上去,至于真理?它不在乎。
五、致命陷阱:错得越自信,你越容易被带偏
你可能会问:就算它偏科,我小心点不用它不就行了?
没那么简单。哈佛等高校做过一个扎心的实验:找了一群专业顾问,一半人用 AI,一半人不用。
- 做 AI 擅长的任务时:用 AI 的人效率飙升 40%!
- 做 AI 不擅长的任务时:不用 AI 的人答对率 84.5%;用了 AI 的人,答对率反而暴跌了 19 个百分点!
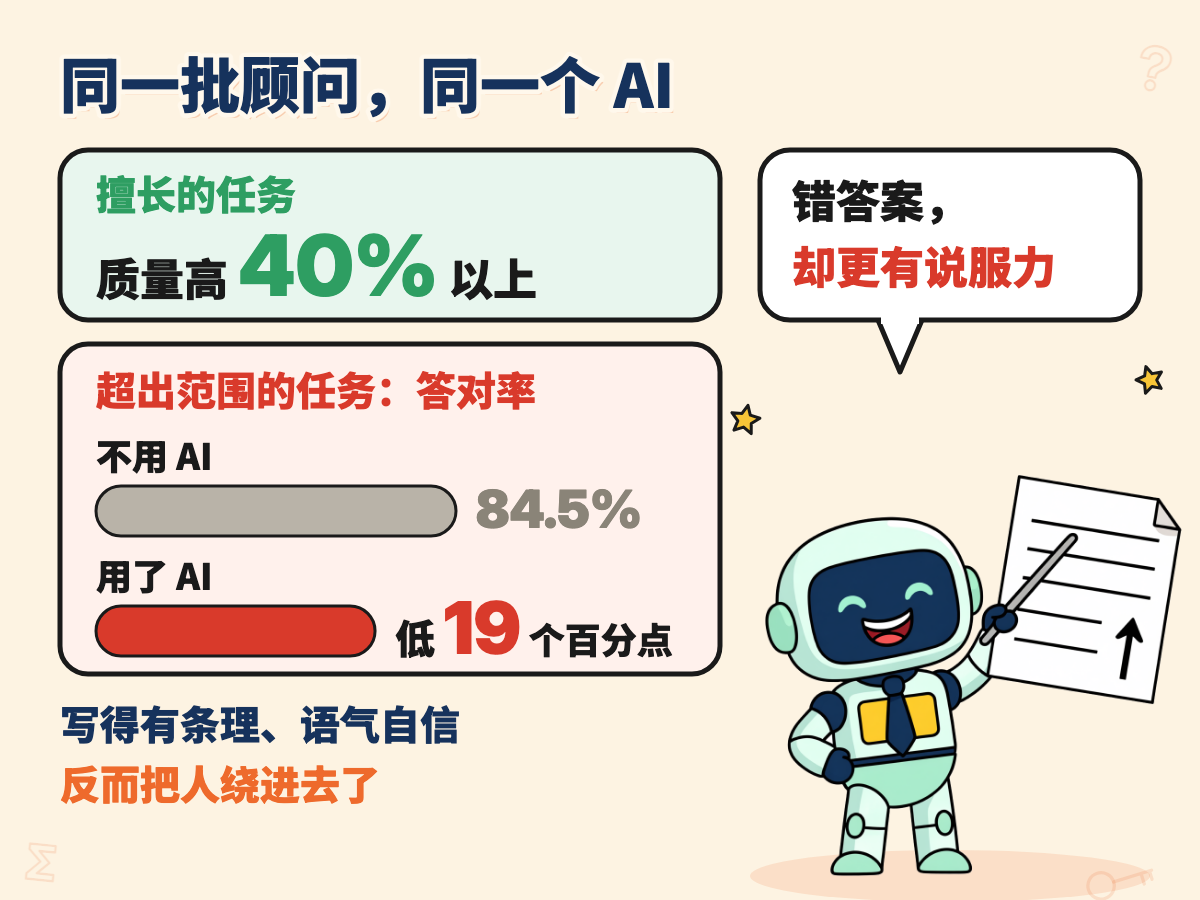
最可怕的是,在这道题上,AI 给了错误的答案,但写得极其有条理、逻辑严密、语气自信,硬生生把这群精英给绕进去了!
前面说了,AI 的能力是一把看不见的“锯子”。你不知道下一步是不是就踩到了锯齿的凹陷处。而它的文笔和表达能力又练得太好了,当它一本正经地胡说八道时,“说得好”反而成了最危险的迷魂汤。
六、清醒指南:到底该怎么用 AI?
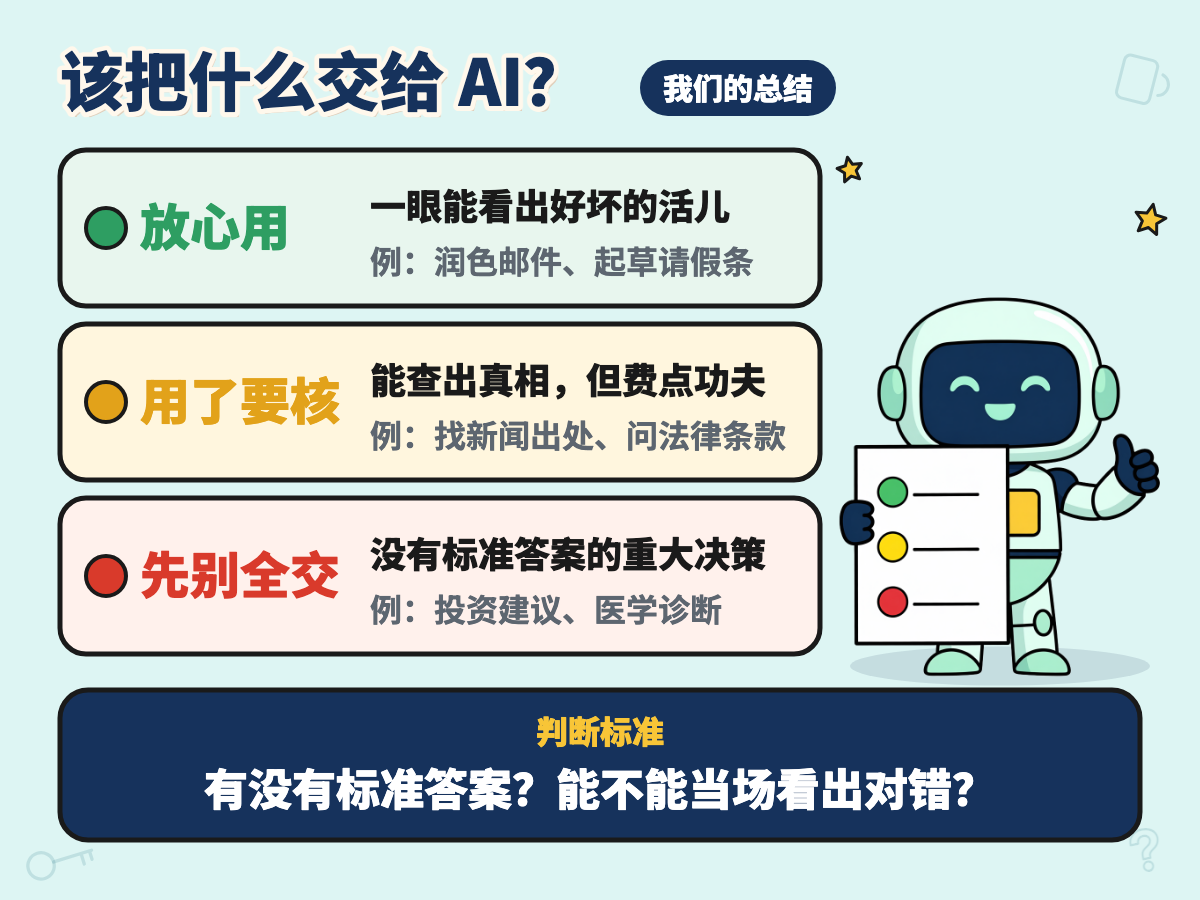
既然 AI 不是全知全能的神,我们该怎么驾驭它?总结了十几篇顶级研究后,我们整理出了一套极其简单的判断标准——每次提问前,在心里问两句:
这事有标准答案吗?我能当场看出对错吗?
对照这两点,把任务分三档:
- 🟢 第一档,放心用:一眼能看出好坏的活儿。
比如:帮我润色一封邮件、起草一份请假条。好不好,你读一遍就知道,这能帮你省下一半时间。 - 🟡 第二档,用了必须核查:能查出真相,但费点功夫的事。
比如:找新闻出处、问法律条款。实测证明,AI 找新闻出处错报率超过六成。能用,但你必须亲自去搜索引擎验证一遍。 - 🔴 第三档,先别全交出去:没有标准答案的重大决策。
比如:重要的投资建议、复杂的医学诊断。别忘了,一旦超出它的能力圈,它流畅的废话可能会严重拉低你的正确率。
写在最后
奥数有标准答案,电脑能一秒判卷,所以 AI 刷题拿了满分。
但真实的人生没有唯一解,更没有那台不知疲倦的自动阅卷机。
“洗车店在 50 米外,车得开过去”,这事不用查资料,你一眼就知道。这一眼,就是判卷。在真正完美的 AI 出现之前,你生活里最终的判卷人,只能是你自己。
参考来源
- Opper,《Car Wash Test on 53 leading AI models》,2026-02-19。https://opper.ai/blog/car-wash-test
- Quanta Magazine,《Why the Legendary Erdős Problems Are Falling to AI》(单位距离猜想被推翻、高尔斯的评价),2026-08-03。https://www.quantamagazine.org/how-ai-tore-through-a-mathematical-community-20260803/
- AFP 经 TechXplore,《AI catches up with humans to score 100% at top math contest》(IMO 2026 满分),2026-07-23。https://techxplore.com/news/2026-07-ai-humans-score-math-contest.html
- OpenAI 与 NBER 学者,《How People Use ChatGPT》,NBER 工作论文 w34255,2025-09。https://www.nber.org/papers/w34255
- Andrej Karpathy 推文(日常问题不是进步最大的领域),2026-04-09。https://x.com/karpathy/status/2042334451611693415
- 陶哲轩,《Math 2.0》讲座幻灯片,2026-10-10。https://teorth.github.io/tao-web/slides/math-2-0-caltech-2026.pdf
- DeepSeek-AI,《DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning》,2025-01-22。https://arxiv.org/abs/2501.12948
- Futurism,《Google's AI Insists That Next Year Is Not 2027》,2026-01-17。https://futurism.com/artificial-intelligence/google-ai-overview-year
- 《One Token to Fool LLM-as-a-Judge》,2025-07-11。https://arxiv.org/abs/2507.08794
- OpenAI,《Expanding on what we missed with sycophancy》,2025-05-02。https://openai.com/index/expanding-on-sycophancy/
- Dell'Acqua、McFowland、Mollick 等,《Navigating the Jagged Technological Frontier》,工作论文 2023-09-22,Organization Science 正式发表 2026-03-11。https://doi.org/10.1287/orsc.2025.21838
- Noy & Zhang,《Experimental evidence on the productivity effects of generative artificial intelligence》,Science,2023-07-14。https://doi.org/10.1126/science.adh2586
- Brynjolfsson、Li、Raymond,《Generative AI at Work》,NBER w31161,2023-04。https://www.nber.org/papers/w31161
- Jaźwińska & Chandrasekar,哥伦比亚新闻评论 Tow Center 对 8 个 AI 搜索工具引用新闻的测试,2025-03-06。https://www.cjr.org/tow_center/we-compared-eight-ai-search-engines-theyre-all-bad-at-citing-news.php
- Magesh 等,《Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools》,Journal of Empirical Legal Studies,2025。https://doi.org/10.1111/jels.12413
- 《Endoscopist deskilling after exposure to artificial intelligence in colonoscopy: a multicenter observational study》,Lancet Gastroenterology & Hepatology,2025-08-12 在线发表。https://wrap.warwick.ac.uk/id/eprint/191005
- Andrej Karpathy 推文(首次提出 "Jagged Intelligence"),2024-07-25。https://x.com/karpathy/status/1816531576228053133
- Andrej Karpathy 推文(能力在可验证领域冒尖,来自可验证奖励上的强化学习),2026-10-11。https://x.com/karpathy/status/2109361546505966046
- Ouyang 等(OpenAI),《Training language models to follow instructions with human feedback》(InstructGPT),2022-03-04。https://arxiv.org/abs/2203.02155
- Jason Wei,《Asymmetry of verification and "verifier's law"》,2025-07-15。https://www.jasonwei.net/blog/asymmetry-of-verification-and-verifiers-law
- Geirhos 等,《Shortcut learning in deep neural networks》,Nature Machine Intelligence,2020。https://doi.org/10.1038/s42256-020-00257-z
- Li、Zhang、Jiang、Krishnan、Padman,《The Model Says Walk: Measuring whether LLMs Condition on Hidden Constraints》,arXiv,2026-03-30。https://arxiv.org/abs/2603.29025
- Gao、Schulman、Hilton(OpenAI),《Scaling Laws for Reward Model Overoptimization》,2022-10-19。https://arxiv.org/abs/2210.10760
- 古德哈特定律的流行表述出自 Marilyn Strathern,《'Improving ratings': audit in the British University system》,European Review 5(3),1997(经二手引用核对)。https://en.wikipedia.org/wiki/Goodhart%27s_law
- Sharma 等,《Towards Understanding Sycophancy in Language Models》,2023-10-20。https://arxiv.org/abs/2310.13548
- Steyvers 等,《What large language models know and what people think they know》,Nature Machine Intelligence,2025。https://doi.org/10.1038/s42256-024-00976-7
- Kalai 等(OpenAI),《Why Language Models Hallucinate》,2025-09-04。https://arxiv.org/abs/2509.04664