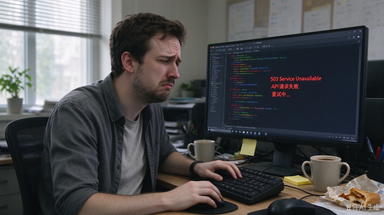
今早九点,技术群里一张表情包直接炸锅:503。
我当时正在调试批处理脚本,前面跑的都顺风顺水,下一秒返回结果全线飘红。第一反应肯定怀疑是自己改代码搞出bug,蹲在屏幕前扒日志、核对请求参数、打印中间变量,折腾二十多分钟,死活找不到本地代码的问题。刷群消息才反应过来,DeepSeek网页和Flash API大面积报错,服务暂时不可用。
那一刻我猛然意识到:最近写的不少脚本,很多能力都依赖这个API撑着。
最扎心的不是服务挂了,是我们下意识默认它永远在线
扪心自问,现在写代码的圈子里,不少人直接把大模型API当成水电一样的基础设施。写批量处理脚本,丢几百条数据交给模型处理;写接口,让它生成代码片段;自己搭个本地小工具,复杂逻辑直接交给大模型。
平时调用稳的时候,体验很爽。一旦上游服务宕机,脚本直接卡死,还在不停发起重试,控制台错误日志疯狂刷屏。
群里有个老哥更倒霉,前一晚刚把公司自动化流程全量切到DeepSeek,汇报的时候还说能降本增效。第二天一早业务就停了,老板过来询问情况,他对着键盘沉默半天,只能回复:上游服务波动,正在排查。
为什么大模型API崩起来比普通接口狠得多
普通Web接口挂了,扩容容器、增加副本,短时间就能恢复。大模型推理服务完全是另一回事,瓶颈卡在显存资源、KV缓存池,prefill预填充和decode解码阶段资源占用差异巨大。请求堆积之后显存碎片飙升,调度器排队堵塞,就算服务恢复,积压的请求队列也需要慢慢排空,没法瞬间满血。
还有很常见的重试风暴。客户端检测超时就无脑重发请求,本就过载的集群压力翻倍,直接进入雪崩正反馈。上游服务挂掉的时候,盲目的重试不是救场,是火上浇油。
程序员踩坑学到的经验:外部依赖一定要做好兜底
这次故障给习惯调用大模型API的开发者上了一课:
第一,熔断机制一定要加上。连续多次失败直接切断请求,不要死循环重试。很多时候你以为在抢救任务,实际在加剧上游压力。
第二,不要单点依赖。核心链路最好准备备选方案,备用通道哪怕平时闲置,出问题的时候就是兜底方案。
第三,日志区分错误类型。4xx属于参数错误,重试多少次都没用;5xx是服务端异常;超时单独处理。所有错误统一重试,纯粹浪费token。
这些知识点看教程都能刷到,但不亲身踩坑,很难真正记牢。
最近不少圈内朋友都在看新机会,想找稳定性更好的研发岗。技术大厂,前端 - 后端 - 测试,全国均有机会。待遇和稳定性都还不错~感兴趣可以试试:https://jsj.top/f/o38ijj
一个真实的圈内段子
群里另一位老哥,自己写了个本地代码辅助工具。早上API故障的时候他完全不知情,一直在反复调整temperature、修改prompt,一直在怀疑自己提示词写得不行。足足折腾两个小时,才发现根源是上游API挂了。
他那句话我记到现在:"我以为是我的prompt不够好,结果是它的服务器不够好。"
结尾
下午服务恢复,脚本正常跑起来,一切回归原样。不过我顺手更新了代码:增加熔断逻辑、配置备选API通道、重写了重试策略。
谈不上有多谨慎,只是这次故障算是一次昂贵的线上演练。谁也说不准下一个"号称永不宕机"的服务什么时候翻车。趁着服务正常的时候,提前铺好后路总归没错。